


小红书 AllSpark 团队开源 Iris-mini 与 Iris-pro 两个搜索智能体模型,权重已可从 Hugging Face 下载。两个版本分别采用 35B/3B 激活和 397B/17B 激活的混合专家架构,均支持 256K Token 上下文,并配套开放评测框架。
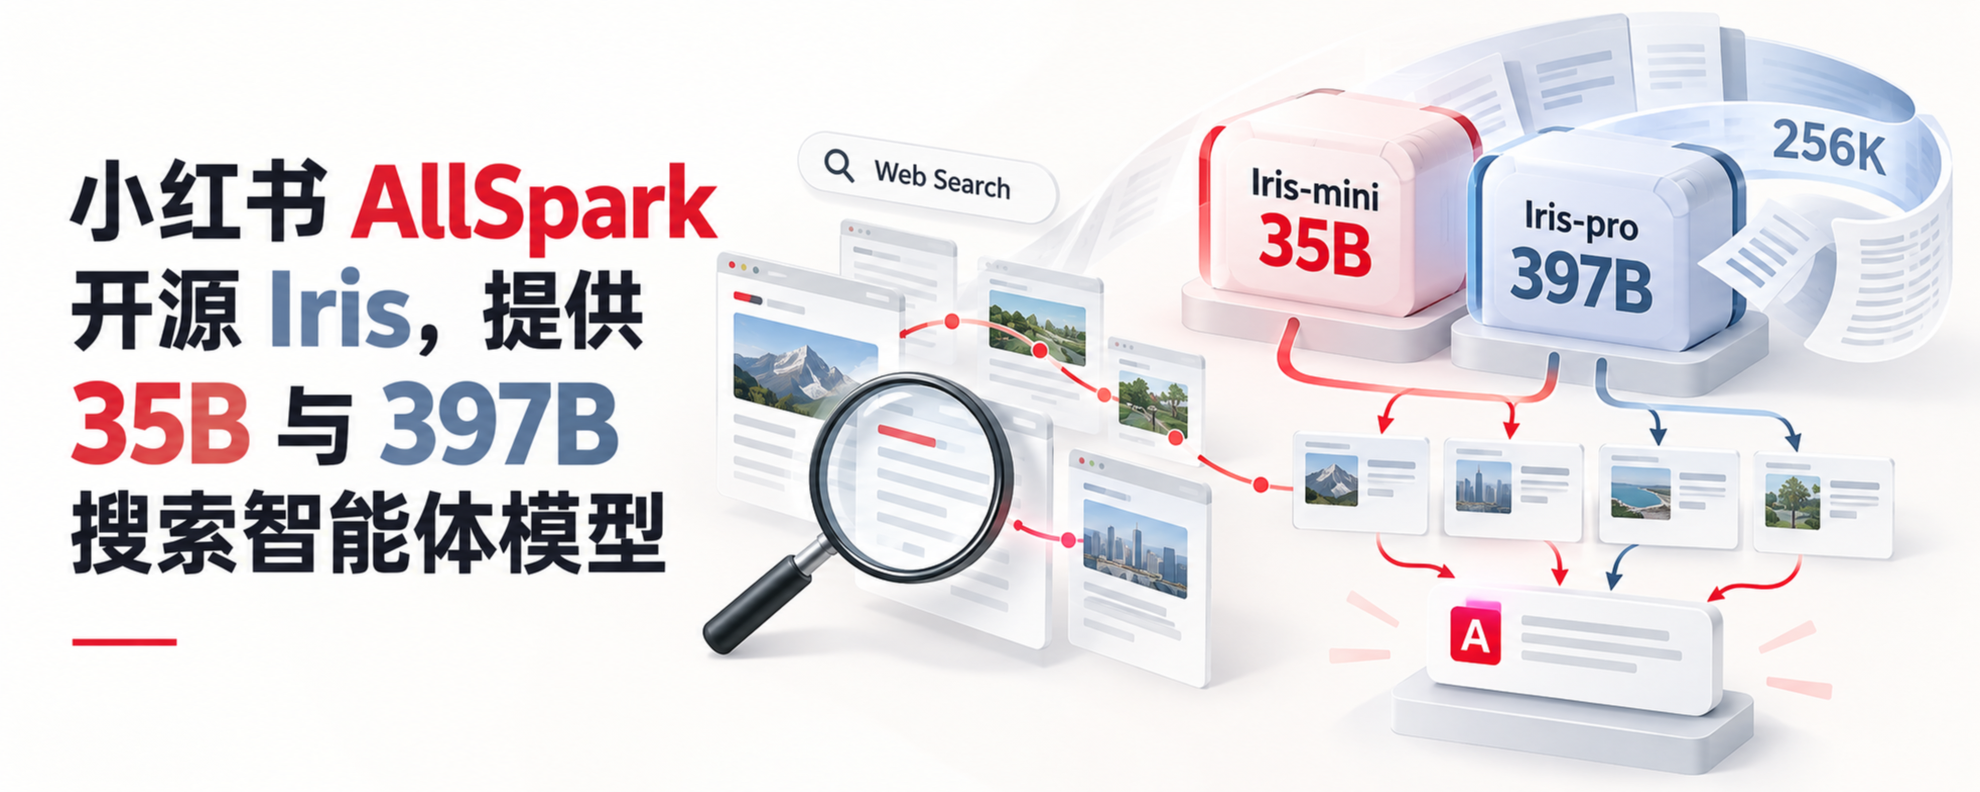
两个版本均支持 256K 上下文
Iris 面向需要多轮检索、阅读网页并整合证据的搜索任务。它不是只返回关键词匹配结果,而是在一次任务中决定搜什么、读取哪些页面、是否继续检索,以及何时整理最终答案。
两个版本都建立在千问混合专家模型之上。混合专家模型不会在每次生成时调用全部参数,而是按输入激活其中一部分,因此总参数量和激活参数量需要分开看。
| 模型 | 基础模型 | 总参数 / 激活参数 | 上下文 | 权重许可证 |
|---|---|---|---|---|
| Iris-mini | Qwen3.6-35B-A3B | 35B / 3B | 256K Token | Apache 2.0 |
| Iris-pro | Qwen3.5-397B-A17B | 397B / 17B | 256K Token | Apache 2.0 |
Iris-mini 每次激活 256 个专家中的 8 个;Iris-pro 每次激活 512 个专家中的 10 个。两套模型页都提供配置文件、聊天模板和 Safetensors 分片权重。小红书此前开源的 dots3-note preview 主要处理图文、视频和音频文档,Iris 的任务则是联网搜索与长链路信息查找。
训练问题从网页链接反向构造
Iris 的训练数据从网页之间的超链接关系开始。系统先把一个种子页面及其链接页面整理成实体关系图,再沿着多个页面之间的关系生成需要多步查找的问题。问题中的直接名称会被改写为描述性线索,减少模型把原词复制到搜索框就得到答案的机会。
生成的问题还要通过两项筛选:参考模型在不给网页证据时无法直接回答,拿到对应证据后能够得到唯一答案。通过筛选的问题会被转成包含推理、工具调用和网页观察的完整轨迹,再按整条轨迹和单个步骤分别过滤。
训练过程交替使用监督微调和强化学习。监督微调让模型先学习筛选后的搜索过程;强化学习阶段让模型连接真实搜索工具执行任务,再把解开的难题和效率较高的轨迹送回下一轮监督训练。这套交替流程在论文中称为 SFT-RL climbing。
评测框架同时控制工具和上下文
GitHub 仓库中的 Iris-Harness 包含单智能体循环、网页搜索与抓取工具、上下文管理配置,以及 BrowseComp、BrowseComp-ZH、DeepSearchQA 和 HLE 四套评测入口。它可以连接提供 OpenAI 兼容接口的模型服务,不限定只能运行 Iris。
框架把上下文管理作为单独变量。discard-all 会在上下文超过阈值时清空已积累的工具历史,从原问题重新开始;retry 会在一次任务没有产出可解析答案时重新执行,并带上简短的排除信息。这样可以分别观察模型本身和外部上下文策略对结果的影响。
开发者可下载权重并接入现有服务
Iris-mini 和 Iris-pro 的 Hugging Face 页面均为公开、无需申请访问的模型仓库。模型卡提供 SGLang 启动示例,并通过 OpenAI Function Calling 格式调用搜索工具;评测框架随后通过 OpenAI 兼容地址连接模型服务。
部署规模需要与模型体量匹配。Iris-mini 的示例采用 4 路张量并行,Iris-pro 的示例采用 8 路张量并行和 8 路专家并行,后者需要多节点或容量较大的单节点。开发者可以先从 Iris-mini 和评测框架入手,再按硬件条件调整并行参数与上下文长度。
原始来源
以下资料用于核对本文信息;价格、开放范围与产品状态请以来源的最新说明为准。
- 小红书 AllSpark 发布 Iris:同量级最强开源 Search Agent — 发布主体、项目名称与公开入口
- Iris: Climbing to the Search Frontier — 模型规格、数据构造与训练方法
- AllSpark Research Iris — 评测框架、运行配置与项目文件
- AllSpark Research Iris-mini — Iris-mini 权重、基础模型、许可证与部署示例
- AllSpark Research Iris-pro — Iris-pro 权重、基础模型、许可证与部署示例