


OpenAI 建议 GPT-6 Astra 用户重新审计 Skills、
AGENTS.md和任务提示词:Skill 描述要缩短并收窄触发范围,多流程内容改为按需加载,仓库指令则按任务类型指向相关文档和测试。
Skill 描述会竞争初始上下文
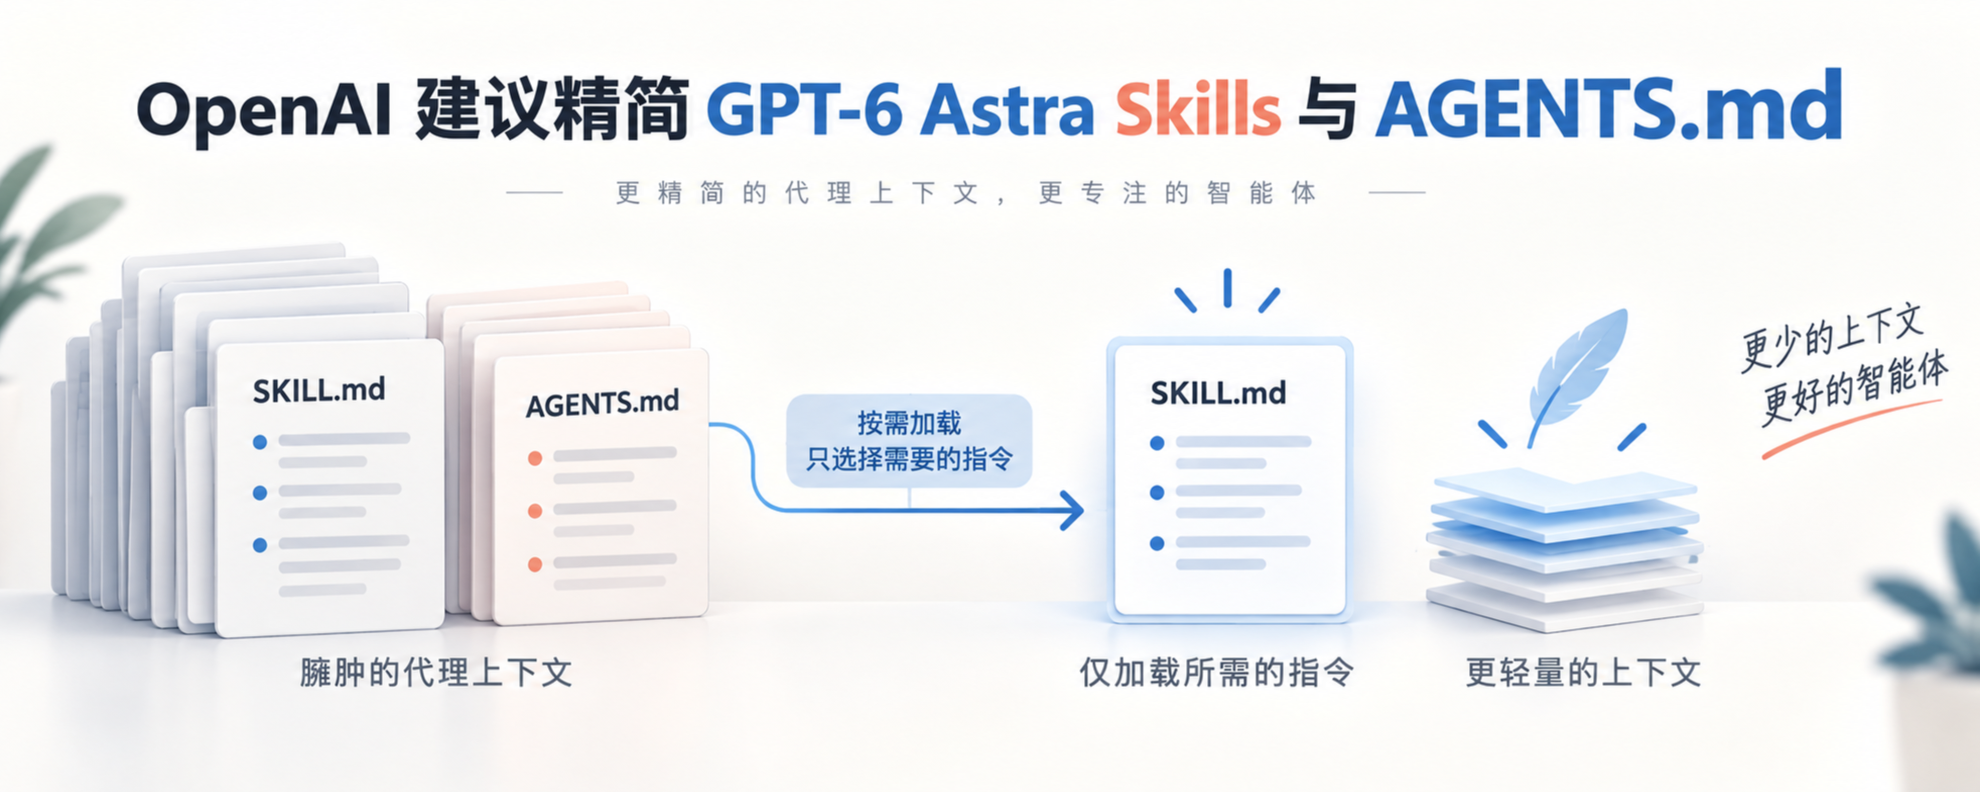
Codex 在决定是否调用 Skill 之前,会先看到每个 Skill 的名称和描述。初始 Skill 列表最多使用模型上下文窗口的 2%;无法确定窗口时,上限为 8000 个字符。Skill 太多时,描述会先被缩短,数量更大时还可能有 Skill 不出现在初始列表中。
描述的任务不是解释整套工作流,而是帮助模型决定“什么时候应该加载”。它应先写清关键用途和触发词,再收窄适用范围。“处理任何数据库工作”会让迁移 Skill 在查询、模型或持久化任务中误触发;“新增、修改或审核迁移时使用”则能直接界定范围。
多流程 Skill 改成按需加载
Skill 适合封装可重复的任务指令、参考资料和脚本。模型选中 Skill 后,才会读取完整的 SKILL.md。因此,同时包含多种工作流时,根文件只需保留选择路径和关键约束,把详细模板、案例和脚本说明放到支持文档中。模型在确定分支后再读对应内容。
过度细化的步骤也需要删减。只有输入、输出、安全边界或团队标准要求确定性时,才需要保留强制流程。通用任务不必为每个可能的分支预先写成长清单。
AGENTS.md 负责路由,不是预加载所有文档
Codex 启动时会把全局指令、项目根目录到当前目录之间的 AGENTS.md 组成一条指令链,更靠近当前目录的规则放在后面,可以覆盖前面的广泛规则。默认情况下,合并后的项目指令读取到 32 KiB 即停止追加。
与其要求每次编辑都通读架构、数据库和部署文档,不如给出条件化路由:改服务边界时读架构文档,改 Schema 时读数据库文档,准备部署时再读部署说明。这会保留项目约定,同时避免与当前任务无关的文档占用上下文。
GPT-6 Astra 的运行行为、委派和测试强度可以在现有提示指南中单独配置。本次清理的重点是删掉过时的重复规则,而不是再加一层新指令。
审批点和完成条件要重新校准
为了阻止早期模型越权操作,一些团队会把“每一步都询问”写进 Skill 或 AGENTS.md。GPT-6 Astra 可能会严格执行这类旧边界,在安全的本地分析、修改和测试之间频繁停下。更具体的写法是保留真正会改变目标或产生外部影响的确认点,并明确授权哪些本地流程可以连续完成。
完成条件也不能只写“做出第一版”。如果任务要求把结果跑起来、检查输出并修复失败,就应把这些动作一起写成终止条件,让指定验证成为交付的一部分。
按这个顺序审计现有指令
- 统计已安装的 Skills,优先处理描述很长、范围重叠或容易误触发的项目。
- 为每个 Skill 留下一个聚焦任务,在描述前部写明关键用途和触发词。
- 把长案例、多分支步骤和仅在特定情况使用的资料移到支持文档,由根文件按需路由。
- 把
AGENTS.md中的全量预读要求改成按任务类型读取,删掉已过时的项目地图和测试规则。 - 重新划定确认点,同时把实现、运行、检查和修复写入需要持续完成的任务边界。
原始来源
以下资料用于核对本文信息;价格、开放范围与产品状态请以来源的最新说明为准。
- Rethinking skills and prompts for GPT-6 Astra | OpenAI Developers — GPT-6 Astra 的 Skill、AGENTS.md、决策边界与完成条件建议
- Build skills | OpenAI Developers — Skill 渐进披露、描述预算与触发方式
- Custom instructions with AGENTS.md | OpenAI Developers — AGENTS.md 的发现顺序、覆盖规则与默认大小上限