<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>51AllAI</title>
  
  <subtitle>探索 AI 的无限可能</subtitle>
  <link href="https://51allai.com/atom.xml" rel="self"/>
  
  <link href="https://51allai.com/"/>
  <updated>2026-11-18T13:57:31.000Z</updated>
  <id>https://51allai.com/</id>
  
  <author>
    <name>51AllAI</name>
    
  </author>
  
  <generator uri="https://hexo.io/">Hexo</generator>
  
  <entry>
    <title>腾讯正式发布 Hy4 flash，百万 Token 输入价 0.5 元</title>
    <link href="https://51allai.com/posts/2026/11/tencent-hy4-flash/"/>
    <id>https://51allai.com/posts/2026/11/tencent-hy4-flash/</id>
    <published>2026-11-18T13:57:31.000Z</published>
    <updated>2026-11-18T13:57:31.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>腾讯混元于 11 月 16 日正式发布 Hy4 flash，支持图文输入和约 100 万 Token 上下文。腾讯云 TokenHub 的 API 目录价为每百万 Token 输入 0.5 元、输出 2 元，在线推理限时五折。11 月 18 日，腾讯推出三个可下载版本，供开发者自行部署。<br><img src="https://images.51allai.com/blog/tencent-hy4-flash-cover_20261118_220354.png" alt="腾讯混元 Hy4 flash 发布与百万 Token 输入价格封面" fetchpriority="high" decoding="async"></p></blockquote><h2 id="WorkBuddy-可试用，API-支持图文输入"><a href="#WorkBuddy-可试用，API-支持图文输入" class="headerlink" title="WorkBuddy 可试用，API 支持图文输入"></a>WorkBuddy 可试用，API 支持图文输入</h2><p>Hy4 flash 是腾讯混元面向日常办公和高频调用推出的语言模型。它可以同时接收文字和图片，再用文字回答。例如，用户可以上传一张表格截图，让模型提取其中的数字，再按指定格式整理。</p><p>普通用户可以在 <a href="https://www.workbuddy.cn/">WorkBuddy</a> 的模型选项中选择 Hy4 flash，免费体验活动持续到 11 月 30 日。模型也已接入元宝、企业微信、QQ、ima 和 Marvis。</p><p>在腾讯云 TokenHub，Hy4 flash 的上下文窗口约为 100 万 Token，单次最大输入和输出分别为 960K 和 64K Token。Token 是模型处理文本等内容时使用的计量单位，上下文窗口会容纳本次输入、历史内容和模型生成的回答。</p><h2 id="TokenHub-在线推理五折持续到-11-月-30-日中午"><a href="#TokenHub-在线推理五折持续到-11-月-30-日中午" class="headerlink" title="TokenHub 在线推理五折持续到 11 月 30 日中午"></a>TokenHub 在线推理五折持续到 11 月 30 日中午</h2><p>按每百万 Token 计算，Hy4 flash 的目录价为未命中缓存的输入 0.5 元、缓存命中的输入 0.02 元、输出 2 元。与 Hy4 的目录价相比，三项价格分别是原来的 1&#x2F;12、1&#x2F;15 和 1&#x2F;9。缓存价适用于重复输入中实际命中缓存的部分。<br><img src="/%E5%BE%85%E8%A1%A5%E5%9B%BE" alt="腾讯混元 Hy4 flash 与 Hy4 的 API 目录价对比图" loading="lazy" decoding="async"></p><p>TokenHub 的在线推理五折活动持续至 2026 年 11 月 30 日 12:00（北京时间）。活动期内，每百万 Token 的未缓存输入、缓存命中输入和输出分别为 <strong>0.25 元、0.01 元、1 元</strong>。一批请求累计使用 100 万未缓存输入 Token、生成 10 万输出 Token，按活动价合计 0.35 元，按目录价合计 0.70 元。</p><h2 id="开发者可接-API，也可下载部署"><a href="#开发者可接-API，也可下载部署" class="headerlink" title="开发者可接 API，也可下载部署"></a>开发者可接 API，也可下载部署</h2><p>在 <a href="https://cloud.tencent.com/tokenhub/hy4-flash">腾讯云 TokenHub</a> 接入时，模型 ID 为 <code>hy4-flash</code>，可选 OpenAI Chat Completions、Responses 或 Anthropic Messages 兼容接口。模型也已在 <a href="https://openrouter.ai/tencent/hy4-flash">OpenRouter</a> 上线，ID 为 <code>tencent/hy4-flash</code>。仍在 TokenHub 调用 <code>hy4-preview</code> 的开发者可以提前测试迁移，平台计划在 12 月 7 日下线该模型。此前的版本规格与价格可参阅 <a href="/posts/2026/08/tencent-hy4-preview/">Hy4 preview 发布时的接入说明</a>。</p><p>腾讯于 11 月 18 日开源 Hy4 flash 系列。<a href="https://github.com/Tencent-Hunyuan/Hy4-flash#model-links">混元模型仓库</a> 汇总了 Hugging Face、ModelScope 和 GitCode 的下载入口。三个版本面向不同用法。</p><ul><li><strong>Hy4 flash</strong> 是完成指令微调的版本，可直接用于对话和执行指令。</li><li><strong>Hy4 flash-FP8</strong> 是指令版的低精度版本，通过减少参数的存储精度降低显存占用。</li><li><strong>Hy4 flash-base</strong> 是预训练基础版，适合在此基础上继续训练。</li></ul><p>三个版本采用 Tencent Hy License 1.0。许可第 10 节列有针对大型模型即服务业务的附加商用条款。</p>]]></content>
    
    
    <summary type="html">腾讯正式发布混元 Hy4 flash，支持图文输入和约百万 Token 上下文。腾讯云 TokenHub 每百万 Token 目录价为输入 0.5 元、输出 2 元，在线推理限时五折。本文梳理 WorkBuddy 试用、API 接入和三个开源版本的区别。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="open-source" scheme="https://51allai.com/tags/open-source/"/>
    
    <category term="tencent" scheme="https://51allai.com/tags/tencent/"/>
    
    <category term="hunyuan" scheme="https://51allai.com/tags/hunyuan/"/>
    
  </entry>
  
  <entry>
    <title>OpenAI 发布 GPT-6.2 Astra 和 Sol，接入 Work 与 Codex</title>
    <link href="https://51allai.com/posts/2026/11/openai-gpt-62-astra-sol/"/>
    <id>https://51allai.com/posts/2026/11/openai-gpt-62-astra-sol/</id>
    <published>2026-11-18T01:30:19.000Z</published>
    <updated>2026-11-18T01:30:19.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>OpenAI 于 11 月 17 日发布 GPT-6.2 Astra 和 GPT-6.2 Sol，两款模型开始向 ChatGPT Work 与 Codex 的付费用户开放，并同步提供 API。Astra 面向复杂专业任务，输入和输出单价较 GPT-6 Astra 降低 20%；Sol 面向日常编程与办公，沿用 GPT-6.1 Sol 的 API 价格。<br><img src="https://images.51allai.com/blog/openai-gpt-62-astra-sol-cover_20261118_093635.png" alt="GPT-6.2 Astra 与 Sol 接入 ChatGPT Work、Codex 和 API 主题封面" fetchpriority="high" decoding="async"></p></blockquote><h2 id="Astra-处理复杂项目，Sol-面向日常工作"><a href="#Astra-处理复杂项目，Sol-面向日常工作" class="headerlink" title="Astra 处理复杂项目，Sol 面向日常工作"></a>Astra 处理复杂项目，Sol 面向日常工作</h2><p><a href="https://openai.com/index/introducing-gpt-6-2-astra-sol/">GPT-6.2 Astra 和 Sol</a> 是两款可以结合资料与工具完成任务的模型。Astra 的使用场景包括跨多个服务排查代码错误、修改并测试软件，以及把研究资料整理成符合给定模板的演示文稿。Sol 则面向日常代码修改、报告起草，或把项目说明、会议记录和时间表整理成执行计划。</p><p>两款模型都接受文本和图片输入，输出文本。通过工具调用，它们可以搜索网页、查找文件、运行代码或操作计算机。工具调用指模型在处理任务时使用外部软件执行步骤，具体能用哪些工具取决于所在客户端或应用的配置。</p><p>在 API 中，两款模型的上下文窗口均为 <strong>105 万 Token</strong>，最大输入为 92.2 万 Token，最大输出为 12.8 万 Token。Token 是模型处理内容的计量单位；上下文窗口决定一次请求能够容纳多少指令、资料和对话，不能直接换算成固定的中文字数。</p><h2 id="在-Work-与-Codex-中选择，普通-Chat-不在此次更新范围内"><a href="#在-Work-与-Codex-中选择，普通-Chat-不在此次更新范围内" class="headerlink" title="在 Work 与 Codex 中选择，普通 Chat 不在此次更新范围内"></a>在 Work 与 Codex 中选择，普通 Chat 不在此次更新范围内</h2><p>ChatGPT Work 与 Codex 的支持套餐包括 Plus、Pro、Business、Enterprise 和 Edu。Work 可通过网页、移动端和桌面端使用；Codex 提供应用和命令行入口。Enterprise 和 Edu 工作空间中的两款模型默认关闭，需要管理员启用。</p><p>使用桌面应用时，先通过 <code>Menu → Check for Updates</code> 更新并重启，再进入 Work 或 Codex，在输入框下方选择模型和推理强度。如果界面显示 Power 滑块，可打开 Advanced 选择具体模型。开放采用分阶段方式，账户能否看到选项还取决于套餐和工作空间权限。</p><p>Codex CLI 也需要更新到最新版本。交互会话中可用 <code>/model</code> 切换模型，启动时也可以直接指定：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">codex --model gpt-6.2-astra</span><br><span class="line">codex --model gpt-6.2-sol</span><br></pre></td></tr></table></figure><p>API 的最大窗口与客户端默认配置需要分开看。Codex 中 Astra 默认使用 27.2 万 Token 上下文，Sol 默认使用 50 万 Token；需要更长上下文时，可在 <code>config.toml</code> 中调整 <code>model_context_window</code>。模型入口和配置方式可查看 <a href="https://learn.chatgpt.com/docs/models">Work 与 Codex 模型使用说明</a>。</p><p>这次更新的入口是 Work 和 Codex，普通 Chat 对话没有加入两款 6.2 模型。此前的 <a href="/posts/2026/10/chatgpt-gpt-6-intelligent-ui/">ChatGPT 对话模型升级与可交互回答</a>属于另一项更新。</p><h2 id="Astra-输入输出降价-20-，Sol-价格保持不变"><a href="#Astra-输入输出降价-20-，Sol-价格保持不变" class="headerlink" title="Astra 输入输出降价 20%，Sol 价格保持不变"></a>Astra 输入输出降价 20%，Sol 价格保持不变</h2><p>以下为 Standard 处理档位的 API 单价，单位均为<strong>美元／百万 Token</strong>：</p><table><thead><tr><th>计费项目</th><th align="right">GPT-6 Astra</th><th align="right">GPT-6.2 Astra</th><th align="right">GPT-6.2 Sol</th></tr></thead><tbody><tr><td>输入</td><td align="right">10.00</td><td align="right">8.00</td><td align="right">2.00</td></tr><tr><td>缓存读取</td><td align="right">1.00</td><td align="right">0.40</td><td align="right">0.10</td></tr><tr><td>输出</td><td align="right">50.00</td><td align="right">40.00</td><td align="right">10.00</td></tr></tbody></table><p>与 <a href="/posts/2026/09/openai-gpt-6-astra/">GPT-6 Astra</a>相比，6.2 Astra 的输入和输出单价均降低 20%，缓存读取降低 60%。Sol 的这三项价格沿用 <a href="/posts/2026/10/gpt-61-sol-chatgpt-codex/">GPT-6.1 Sol</a>，均为 6.2 Astra 的四分之一。这里比较的是每 Token 单价，整项任务的费用还取决于实际用量、缓存和工具调用。</p><p>缓存可复用重复出现的提示内容。表中的缓存读取价只适用于命中缓存的输入；写入另行计费。保留 30 分钟时，Astra 和 Sol 的缓存写入价分别为每百万 Token 10 美元、2.50 美元；保留 12 小时则分别为 20 美元、5 美元。</p><p>上述价格适用于输入不超过 27.2 万 Token 的请求。超过这一门槛时，<strong>整次请求</strong>的输入和缓存费率变为 2 倍，输出费率变为 1.5 倍。Batch 批处理按 Standard 的半价计费，Fast 为 2 倍。</p><p>两款模型也提供 Ultrafast 速度档位。API 截至太平洋时间 2027 年 2 月 28 日按 Standard 的 3 倍计费，3 月 1 日起为 6 倍。在订阅中，Pro 500 用户可为两款模型选择 Ultrafast，Pro 200 则先开放 Sol；符合条件的 Enterprise 和 Edu 用户需由管理员启用。</p><h2 id="开发者迁移时要检查接口、推理档位和对话历史"><a href="#开发者迁移时要检查接口、推理档位和对话历史" class="headerlink" title="开发者迁移时要检查接口、推理档位和对话历史"></a>开发者迁移时要检查接口、推理档位和对话历史</h2><p>API 模型 ID 分别为 <code>gpt-6.2-astra</code> 和 <code>gpt-6.2-sol</code>，均支持 Responses 与 Chat Completions。需要搜索、计算机操作或其他工具调用时，必须使用 Responses API。</p><p>新接入可从 <code>medium</code> 推理强度开始。已有请求若使用 <code>none</code> 或 <code>minimal</code>，应改为 <code>low</code> 等受支持档位；这两款模型不接受 <code>none</code>。迁移时还要移除不支持的 <code>temperature</code>、<code>top_p</code> 等参数，完整规则可查看 <a href="https://developers.openai.com/api/docs/guides/latest-model">GPT-6.2 接入与迁移指南</a>。</p><p>多轮任务还要保留已有对话历史的顺序和内容，把新要求追加到后面。6.2 API 检测到对话前缀被改写、切换到较低档模型，或终端用户、组织发生变化时，会丢弃已有推理记录。保持前缀不变，有助于保留推理记录，也让前面的输入继续满足缓存复用条件。</p>]]></content>
    
    
    <summary type="html">OpenAI 发布 GPT-6.2 Astra 和 Sol，接入 ChatGPT Work、Codex 与 API。本文整理使用入口、付费套餐、105 万 Token 上下文与默认窗口差异，说明 Astra 输入输出单价降低 20%、Sol 价格不变，以及缓存费用、长输入附加费和开发者迁移要点。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="chatgpt" scheme="https://51allai.com/tags/chatgpt/"/>
    
    <category term="codex" scheme="https://51allai.com/tags/codex/"/>
    
  </entry>
  
  <entry>
    <title>Suno 上线 Visuals，可生成对口型与歌词视频</title>
    <link href="https://51allai.com/posts/2026/11/suno-visuals-music-video/"/>
    <id>https://51allai.com/posts/2026/11/suno-visuals-music-video/</id>
    <published>2026-11-17T15:45:25.000Z</published>
    <updated>2026-11-17T15:45:25.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>Suno 于 11 月 17 日上线 Visuals，用户可把歌曲库中的作品拖入新工具，生成最长 15 秒的视频片段，再通过文字编辑或在时间线上续接。它支持对口型与歌词视频，使用独立于歌曲积分的视觉积分，Pro 和 Premier 用户可限时获得少量试用积分。<br><img src="https://images.51allai.com/blog/suno-visuals-music-video-cover_20261117_235147.png" alt="Suno Visuals 将歌曲转为对口型视频与歌词视频" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从歌曲库开始生成视频"><a href="#从歌曲库开始生成视频" class="headerlink" title="从歌曲库开始生成视频"></a>从歌曲库开始生成视频</h2><p><a href="https://suno.com/visuals">Suno Visuals</a> 是 Suno 新增的图片与视频创作工具，已开放网页端。用户可以为已有歌曲生成画面，也可以从参考图片或一段文字描述开始，制作视频片段、歌词视频或专辑封面。</p><p>它与 <a href="/posts/2026/09/suno-v6-music-models/">Suno v6 的多模态音乐生成</a>承担不同任务：v6 可以把图片、视频等素材作为生成音乐的参考；Visuals 则让用户为歌曲继续制作视觉内容。</p><p>在网页端使用时，可以按以下顺序开始：</p><ol><li>打开 Visuals 标签页，将歌曲库中的一首歌拖入。</li><li>选择内置原创角色、使用自己的图片，或用文字描述想要的画面。</li><li>生成最长 15 秒的视频片段，再用文字修改，或沿时间线续接。</li><li>按分享需要选择片段时长、画面比例与分辨率。</li></ol><p>15 秒指初次生成的片段长度。需要更长的内容时，可以继续续接和编辑已有片段。</p><h2 id="对口型、歌词样式和画面可以分别处理"><a href="#对口型、歌词样式和画面可以分别处理" class="headerlink" title="对口型、歌词样式和画面可以分别处理"></a>对口型、歌词样式和画面可以分别处理</h2><p>Visuals 提供对口型视频功能，让画面中的角色配合歌曲演唱；歌词视频则将歌词呈现在画面中，用户可以自定义字体和颜色。前者适合以角色演唱为主的片段，后者适合突出歌词内容。</p><p>图片也可以作为创作起点。已有封面或原创角色图的用户，可以用它们引导视觉方向，再通过文字反复调整。需要寻找风格时，<a href="https://suno.com/visuals/inspiration-guide">Visuals 灵感指南</a>提供动画、实拍、灯光、镜头运动等分类示例，便于把模糊的想法改成具体描述。</p><p>Visuals 使用的模型名为 <strong>H3 Move</strong>，基于 MiniMax H3，并针对 Suno 的使用场景做了优化。它是 Suno 内的创作功能，使用入口与计费方式均由 Suno 提供。</p><h2 id="视觉积分与歌曲积分分开计算"><a href="#视觉积分与歌曲积分分开计算" class="headerlink" title="视觉积分与歌曲积分分开计算"></a>视觉积分与歌曲积分分开计算</h2><p>生成视频和图片消耗 Visual credits，即视觉积分；歌曲生成使用 Song credits，即歌曲积分。账户中的歌曲积分不能直接当作视觉积分使用。</p><p>视觉积分消耗量随视频时长、所选质量等设置变化。质量选项分为 Fast 和 Standard：Fast 消耗的视觉积分更少，适合先尝试构图和方向；Standard 面向更复杂的创意。</p><p>目前有三种获取视觉积分的方式：</p><table><thead><tr><th>方式</th><th>视觉积分规则</th></tr></thead><tbody><tr><td>Pro、Premier 限时试用</td><td>获得少量视觉积分，用于体验 Visuals</td></tr><tr><td>单独购买积分包</td><td>所有用户均可通过视觉积分购买页购买，购入积分不过期</td></tr><tr><td>Platinum 订阅</td><td>每月包含 20,000 视觉积分，另有 15,000 歌曲积分</td></tr></tbody></table><p>Platinum 的年付金额为 <strong>1,200 美元</strong>，折合每月 100 美元，税费在结账时计算。订阅内的积分按月提供，当月未用完的额度不结转；这与单独购买的视觉积分不过期是两种规则。</p><p>只想试做几个视频片段的用户，可以先使用已有的试用额度，或从<a href="https://suno.com/pricing/visuals">视觉积分购买页</a>购买积分包。Platinum 同时包含歌曲生成、下载和 Studio 等权益，适合一并比较这些需求后再选择。</p><h2 id="上传图片前需要确认素材使用权"><a href="#上传图片前需要确认素材使用权" class="headerlink" title="上传图片前需要确认素材使用权"></a>上传图片前需要确认素材使用权</h2><p>首次向 Visuals 上传图片或视频时，用户需要确认自己拥有对应文件的使用权。平台会对上传内容、提示词及生成结果进行检查，针对特定艺人、公众人物、版权作品和相关形象设置过滤规则。</p><p>为自己的歌曲制作视频时，可以从原创角色、自己拍摄的照片或文字描述开始，再决定使用对口型演唱、歌词展示还是其他画面形式。</p>]]></content>
    
    
    <summary type="html">Suno 上线 Visuals，可从歌曲、参考图片或文字提示生成对口型视频、歌词视频和封面图，单段视频最长 15 秒，并可在时间线上续接与修改。本文整理网页端使用步骤、歌词样式设置、基于 MiniMax H3 的 H3 Move 模型，以及视觉积分与歌曲积分的区别、试用范围和 Platinum 年付套餐。</summary>


    <category term="多模态" scheme="https://51allai.com/categories/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    
    
    <category term="product-update" scheme="https://51allai.com/tags/product-update/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="audio-generation" scheme="https://51allai.com/tags/audio-generation/"/>
    
    <category term="video-generation" scheme="https://51allai.com/tags/video-generation/"/>
    
    <category term="suno" scheme="https://51allai.com/tags/suno/"/>
    
  </entry>
  
  <entry>
    <title>微博开放 CLI 与 MCP，支持 AI 调用发布和检索接口</title>
    <link href="https://51allai.com/posts/2026/11/weibo-cli-mcp-agent-access/"/>
    <id>https://51allai.com/posts/2026/11/weibo-cli-mcp-agent-access/</id>
    <published>2026-11-17T15:13:35.000Z</published>
    <updated>2026-11-17T15:13:35.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>微博开放平台提供官方命令行工具 weibo-cli 和远程 MCP 服务，可将发布、互动、检索等接口接入脚本与 AI 工作流。使用前需完成开发者认证并开通服务；新用户可领取限次的 7 天体验服务，正式服务按积分调用，充值包从 69 元起。<br><img src="https://images.51allai.com/blog/weibo-cli-mcp-agent-access-cover_20261117_231736.png" alt="微博 CLI 与 MCP 接入 AI 工作流及积分计费示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="把微博操作接入终端和-AI-工具"><a href="#把微博操作接入终端和-AI-工具" class="headerlink" title="把微博操作接入终端和 AI 工具"></a>把微博操作接入终端和 AI 工具</h2><p><a href="https://open.weibo.com/cli">微博 CLI</a> 把发博、评论互动、内容检索和账号数据查询等操作封装成终端命令。CLI 就是命令行工具：人可以逐条输入指令，程序也可以按流程连续调用。</p><p>返回结果支持 JSON、YAML、表格和原始格式。JSON 和 YAML 是便于程序读取的数据格式，因此脚本可以把查询结果交给 AI 整理，再将结果写入自己的报告或运营系统。</p><p>微博同时提供远程 MCP 服务。MCP 是让 AI 应用连接外部工具的通用协议；支持相应连接和授权方式的客户端，可以通过它调用微博能力。需要自己编排脚本的开发者可从 CLI 入手，已有 MCP 客户端的用户则可直接配置远程服务。</p><p>这种接入方式也出现在 <a href="/posts/2026/09/workbuddy-open-platform/">WorkBuddy 开放平台的 CLI 与连接器方案</a> 中：先将业务能力做成工具，再由 AI 应用组织调用步骤。</p><h2 id="安装后，还要完成认证和服务开通"><a href="#安装后，还要完成认证和服务开通" class="headerlink" title="安装后，还要完成认证和服务开通"></a>安装后，还要完成认证和服务开通</h2><p>截至 2026 年 11 月 17 日，npm 上的最新版本为 <code>0.9.8</code>，要求 Node.js 18 或更高版本。软件包提供 <code>weibo</code>、<code>weibo-cli</code> 和 <code>wb</code> 三个命令名，下面统一使用 <code>weibo</code>。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">npm install -g @weibo-ai/weibo-cli</span><br><span class="line">weibo version</span><br></pre></td></tr></table></figure><p>调用平台接口前，先在微博 CLI 控制台使用微博客户端扫码、完成开发者扫脸认证，再到“我的服务”领取体验服务或购买正式积分包。完成这些步骤后，可创建 CLI 授权并在终端登录：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">weibo auth login</span><br><span class="line">weibo auth <span class="built_in">whoami</span></span><br><span class="line">weibo doctor</span><br></pre></td></tr></table></figure><p>登录采用 OAuth 授权，也就是在微博登录页确认这台工具的访问权限。<code>auth whoami</code> 用于确认当前会话，<code>doctor</code> 则检查登录、开发者认证和服务状态。</p><p>在 SSH、远程服务器或容器里，可以改用设备码登录：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">weibo auth login --device</span><br></pre></td></tr></table></figure><p>终端会给出授权网址和验证码，用户仍需在浏览器里确认。设备码让远程环境能够登录，不会省略账号授权步骤。</p><h2 id="用命令清单确认账号能调用什么"><a href="#用命令清单确认账号能调用什么" class="headerlink" title="用命令清单确认账号能调用什么"></a>用命令清单确认账号能调用什么</h2><p>平台命令由服务端清单提供。先查看账号可用范围，再查询具体命令的参数，比直接复制旧教程更合适：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">weibo commands list --available</span><br><span class="line">weibo commands show <span class="built_in">users</span> show_batch/other</span><br><span class="line">weibo me --output table</span><br></pre></td></tr></table></figure><p><code>commands show</code> 会展示命令说明和必填参数，<code>me</code> 用于查看账号、余额和服务信息。常见查询入口包括：</p><table><thead><tr><th>任务</th><th>命令示例</th></tr></thead><tbody><tr><td>读取首页时间线</td><td><code>weibo statuses friends_timeline/biz --count 5 --output json</code></td></tr><tr><td>按昵称查询用户</td><td><code>weibo users show_batch/other --screen_name 来去之间</code></td></tr><tr><td>按关键词检索微博</td><td><code>weibo search statuses/limited --q keyword</code></td></tr><tr><td>查看收到的评论</td><td><code>weibo comments to_me/biz</code></td></tr></tbody></table><p>命令是否可用取决于账号的服务状态和接口范围。为 AI 编排工作流时，可以先从读取时间线、检索内容或整理评论开始，再加入发布与回复步骤。</p><h2 id="7-天体验限次，正式服务按积分调用"><a href="#7-天体验限次，正式服务按积分调用" class="headerlink" title="7 天体验限次，正式服务按积分调用"></a>7 天体验限次，正式服务按积分调用</h2><p>7 天体验服务每个账号只能领取一次，领取前需通过开发者认证。已经领取过体验服务、开通过正式服务或曾付费充值的账号，不能再次领取。</p><p>体验期只开放白名单内的部分接口，不扣积分，但按接口分别限次：读取类通常为每个接口 5 次，写入类通常为每个接口 3 次。多图发博、统计和趋势等能力不在体验服务范围内。</p><p>正式服务通过购买积分包开通，拥有可用积分余额后可调用全部开放接口。当前充值档位如下：</p><table><thead><tr><th>积分包</th><th align="right">价格</th><th align="right">到账积分</th><th align="right">每 1,000 积分价格</th></tr></thead><tbody><tr><td>入门包</td><td align="right">69 元</td><td align="right">23,000</td><td align="right">3 元</td></tr><tr><td>标准包</td><td align="right">198 元</td><td align="right">79,200</td><td align="right">2.5 元</td></tr><tr><td>专业包</td><td align="right">398 元</td><td align="right">199,000</td><td align="right">2 元</td></tr><tr><td>旗舰包</td><td align="right">998 元</td><td align="right">998,000</td><td align="right">1 元</td></tr></tbody></table><p>这些是积分充值价格。实际调用成本还取决于接口按次或按条扣分的规则，不能直接把积分数当作可调用次数。所购积分自到账起有效期为 365 天，过期未用完的积分会失效；写入类 HTTP POST 接口另有每小时合计 60 次的频率限制。</p><p>客户端软件包采用 MIT 许可，平台接口使用则受认证、服务资格、余额和频率限制约束。</p><h2 id="MCP-客户端可直接连接远程服务"><a href="#MCP-客户端可直接连接远程服务" class="headerlink" title="MCP 客户端可直接连接远程服务"></a>MCP 客户端可直接连接远程服务</h2><p>支持 OAuth 授权与 Streamable HTTP 传输的 MCP 客户端，可以按自身配置格式添加以下连接。Streamable HTTP 是通过 HTTP 连接远程 MCP 服务的方式。</p><figure class="highlight json"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="punctuation">&#123;</span></span><br><span class="line">  <span class="attr">&quot;mcpServers&quot;</span><span class="punctuation">:</span> <span class="punctuation">&#123;</span></span><br><span class="line">    <span class="attr">&quot;weibo&quot;</span><span class="punctuation">:</span> <span class="punctuation">&#123;</span></span><br><span class="line">      <span class="attr">&quot;type&quot;</span><span class="punctuation">:</span> <span class="string">&quot;streamableHttp&quot;</span><span class="punctuation">,</span></span><br><span class="line">      <span class="attr">&quot;url&quot;</span><span class="punctuation">:</span> <span class="string">&quot;https://cli.weibo.com/mcp&quot;</span></span><br><span class="line">    <span class="punctuation">&#125;</span></span><br><span class="line">  <span class="punctuation">&#125;</span></span><br><span class="line"><span class="punctuation">&#125;</span></span><br></pre></td></tr></table></figure><p>连接时，客户端会打开浏览器完成微博授权，无需在这段配置里手填静态 Token。账号仍需通过开发者认证，并处于有效体验期或拥有可用正式积分余额。</p><p>发布 AI 生成的博文时，使用者须声明其 AI 生成属性，由系统添加相应标识。将发文、评论或关注等操作接入 AI 工作流时，适合保留执行前的人工确认，核对目标账号、内容和操作范围。</p>]]></content>
    
    
    <summary type="html">微博开放 CLI 与 MCP 接入，可让脚本和 AI 调用发博、评论、内容检索与账号数据接口。本文整理安装登录、开发者认证、命令查询和远程 MCP 配置，并列出 7 天体验服务的范围、69 元起的积分充值档位及调用限制，帮助开发者和内容运营者判断接入方式与实际使用成本。</summary>


    <category term="智能体" scheme="https://51allai.com/categories/%E6%99%BA%E8%83%BD%E4%BD%93/"/>
    
    
    <category term="workflow-automation" scheme="https://51allai.com/tags/workflow-automation/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="developer-tools" scheme="https://51allai.com/tags/developer-tools/"/>
    
    <category term="MCP" scheme="https://51allai.com/tags/MCP/"/>
    
    <category term="weibo" scheme="https://51allai.com/tags/weibo/"/>
    
  </entry>
  
  <entry>
    <title>阿里正式发布 Qwen4-Max，2.4 万亿参数模型开放 API</title>
    <link href="https://51allai.com/posts/2026/11/alibaba-qwen4-max-release/"/>
    <id>https://51allai.com/posts/2026/11/alibaba-qwen4-max-release/</id>
    <published>2026-11-16T12:28:19.000Z</published>
    <updated>2026-11-16T12:28:19.000Z</updated>
    
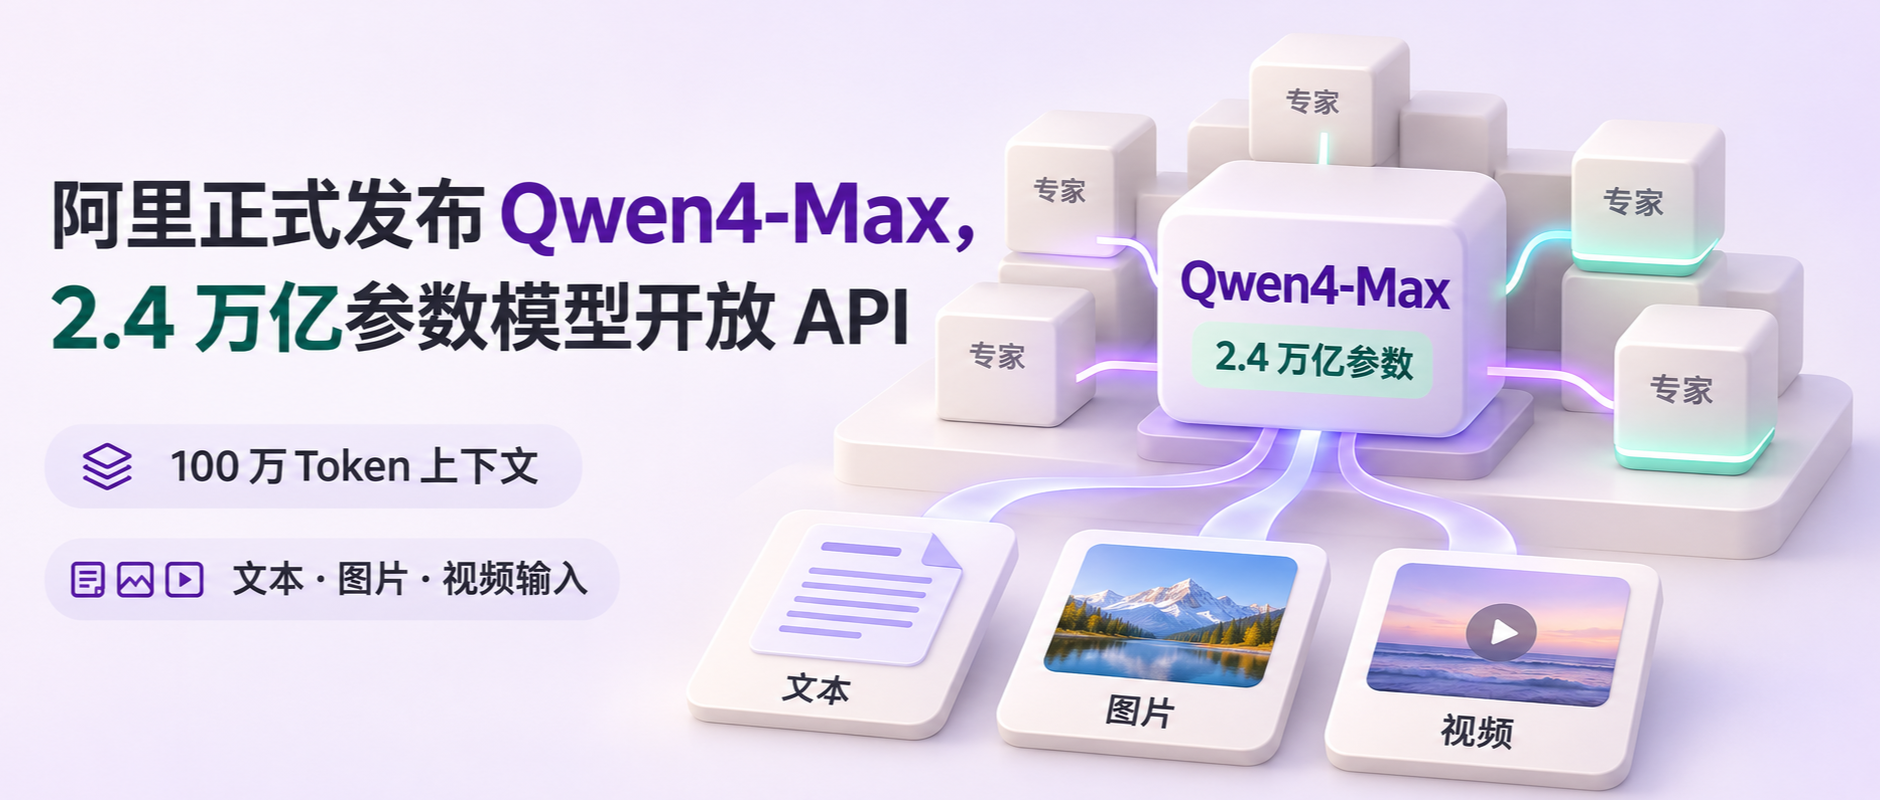
    <content type="html"><![CDATA[<blockquote><p>阿里于 11 月 16 日正式发布 Qwen4-Max，模型规模为 2.4 万亿参数，每个 Token 激活约 710 亿参数，支持百万 Token 上下文与文字、图片、视频输入。正式版已开放按量 API，北京区标准输入、输出价格分别为每百万 Token 10 元、30 元，缓存命中的输入为 0.5 元。<br><img src="https://images.51allai.com/blog/alibaba-qwen4-max-release-cover_20261116_210555.png" alt="阿里 Qwen4-Max 正式版 2.4 万亿参数与多模态 API 主题图" fetchpriority="high" decoding="async"></p></blockquote><h2 id="2-4-万亿参数，每次计算激活约-710-亿"><a href="#2-4-万亿参数，每次计算激活约-710-亿" class="headerlink" title="2.4 万亿参数，每次计算激活约 710 亿"></a>2.4 万亿参数，每次计算激活约 710 亿</h2><p>Qwen4-Max 是千问新一代旗舰多模态模型，采用 MoE（混合专家）架构。这类架构将模型分成多个专家模块，处理输入时只选择其中一部分参与计算。<strong>2.4 万亿是模型的总参数规模，710 亿是每个 Token 激活的参数量</strong>，两者描述的是不同指标。</p><p>参数是模型在训练中学到的数值。相比同为 2.4 万亿规模的 Qwen3.8-Max，新模型每个 Token 激活的参数减少了 25%。这个比例描述参与计算的规模，不能直接换算成用户任务的提速或费用降幅。</p><p>模型可接收文本、图片和视频，并以文本输出。用户可以提交文档、截图或视频，要求提取信息、解释内容或生成代码。图片与视频在这里是供模型理解的输入材料。</p><p>上下文窗口为 <strong>100 万 Token</strong>。Token 是模型处理内容的基本单位，上下文容量决定一次请求能容纳多少输入、对话和生成内容。此前的 <a href="/posts/2026/08/qwen38-max-launch/">Qwen3.8-Max 已支持百万 Token 上下文</a>，这项容量在正式版中延续。</p><h2 id="正式版开放按量-API，标准输入与输出单价下降约-16-7"><a href="#正式版开放按量-API，标准输入与输出单价下降约-16-7" class="headerlink" title="正式版开放按量 API，标准输入与输出单价下降约 16.7%"></a>正式版开放按量 API，标准输入与输出单价下降约 16.7%</h2><p>与 11 月 11 日上线、API 通过 Token Plan 开放的<a href="/posts/2026/11/alibaba-qwen4-max-preview/">限时预览版</a>相比，正式版增加了按量调用入口，模型标识为 <code>qwen4-max</code>。开发者可以按实际输入、输出用量结算，也可通过 Token Plan 使用。</p><p>以下为北京区人民币单价，单位均为每百万 Token；标准输入价格对应未命中缓存的输入。</p><table><thead><tr><th>计费项</th><th align="right">Qwen3.8-Max</th><th align="right">Qwen4-Max 正式版</th></tr></thead><tbody><tr><td>标准输入</td><td align="right">12 元</td><td align="right">10 元</td></tr><tr><td>输出，含思维链与回答</td><td align="right">36 元</td><td align="right">30 元</td></tr></tbody></table><p>两项标准单价均下降约 <strong>16.7%</strong>。按一次任务使用 10 万输入 Token、1 万输出 Token 计算，未命中缓存且不使用额外收费工具时，新模型费用为 <strong>1.30 元</strong>，前代同样用量为 1.56 元。任务实际用了多少 Token，仍会影响最终账单。</p><h2 id="0-5-元是缓存命中价，创建缓存另计"><a href="#0-5-元是缓存命中价，创建缓存另计" class="headerlink" title="0.5 元是缓存命中价，创建缓存另计"></a>0.5 元是缓存命中价，创建缓存另计</h2><p>Qwen4-Max 的显式与隐式缓存命中价均为 <strong>0.5 元／百万输入 Token</strong>。缓存会复用重复输入的公共前缀，例如系统提示词、工具说明和参考文档，减少对同一部分内容的重复计算。</p><p>这个单价只适用于命中的输入部分。未命中的输入按标准输入价结算，输出仍按输出价结算。例如，10 万输入 Token 全部命中已有缓存时，输入部分为 0.05 元；如果同时产生 1 万输出 Token，输出部分仍为 0.30 元。</p><p>显式缓存需要主动创建，北京区保留 5 分钟的创建价为 12.5 元／百万 Token，保留 1 小时为 20 元／百万 Token。上述命中示例不含创建费用。评估缓存是否划算时，应把创建费用和后续复用次数一起算入。</p><h2 id="普通用户直接体验，开发者核对正式版配置"><a href="#普通用户直接体验，开发者核对正式版配置" class="headerlink" title="普通用户直接体验，开发者核对正式版配置"></a>普通用户直接体验，开发者核对正式版配置</h2><p>普通用户可在千问办公、千问应用、Qoder 和 Qwen Studio 等入口体验新模型。需要接入自己软件的开发者，可从<a href="https://www.qianwenai.com/models/qwen4-max">千问 AI 平台 Qwen4-Max 模型页</a>进入控制台，创建 API Key 并配置调用。</p><p>北京区按量 API 的 OpenAI 兼容配置如下：</p><table><thead><tr><th>配置项</th><th>值</th></tr></thead><tbody><tr><td>模型标识</td><td><code>qwen4-max</code></td></tr><tr><td>Base URL</td><td><code>https://cn-beijing.maas.qianwenaiapi.com/compatible-mode/v1</code></td></tr><tr><td>API Key</td><td>对应服务的阿里云百炼 API Key</td></tr></tbody></table><p>模型兼容 OpenAI 与 Anthropic API，支持工具调用、联网搜索和结构化输出。工具调用允许模型请求外部函数执行操作；结构化输出可按约定的 JSON 格式返回结果，便于软件继续处理。</p><p>正式版默认开启思考模式，在回答前先进行推理。思考强度可选 <code>low</code>、<code>high</code>、<code>xhigh</code>，默认 <code>high</code>；思考模式的最大输出预算为 262,144 Token，非思考模式为 131,072 Token，输出计费包含思维链与回答。</p><p>从预览版迁移时，应同时核对模型标识、API Key、服务地址和输出预算。Token Plan 使用套餐专属密钥与地址；上表对应北京区按量接口。先用一项熟悉的任务检查调用结果、Token 用量和费用，再切换现有工作流。</p>]]></content>
    
    
    <summary type="html">阿里于 11 月 16 日正式发布 Qwen4-Max，2.4 万亿参数模型支持百万 Token 上下文和文本、图片、视频输入，并开放按量 API。本文说明 710 亿激活参数、北京区输入与输出价格、缓存计费条件，以及从预览版迁移时需要核对的配置。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="multimodal" scheme="https://51allai.com/tags/multimodal/"/>
    
    <category term="alibaba" scheme="https://51allai.com/tags/alibaba/"/>
    
    <category term="qwen" scheme="https://51allai.com/tags/qwen/"/>
    
  </entry>
  
  <entry>
    <title>OpenAI 更新使用政策，模型中转服务须事先审批</title>
    <link href="https://51allai.com/posts/2026/11/openai-usage-policy-model-access/"/>
    <id>https://51allai.com/posts/2026/11/openai-usage-policy-model-access/</id>
    <published>2026-11-14T13:47:34.000Z</published>
    <updated>2026-11-14T13:47:34.000Z</updated>
    
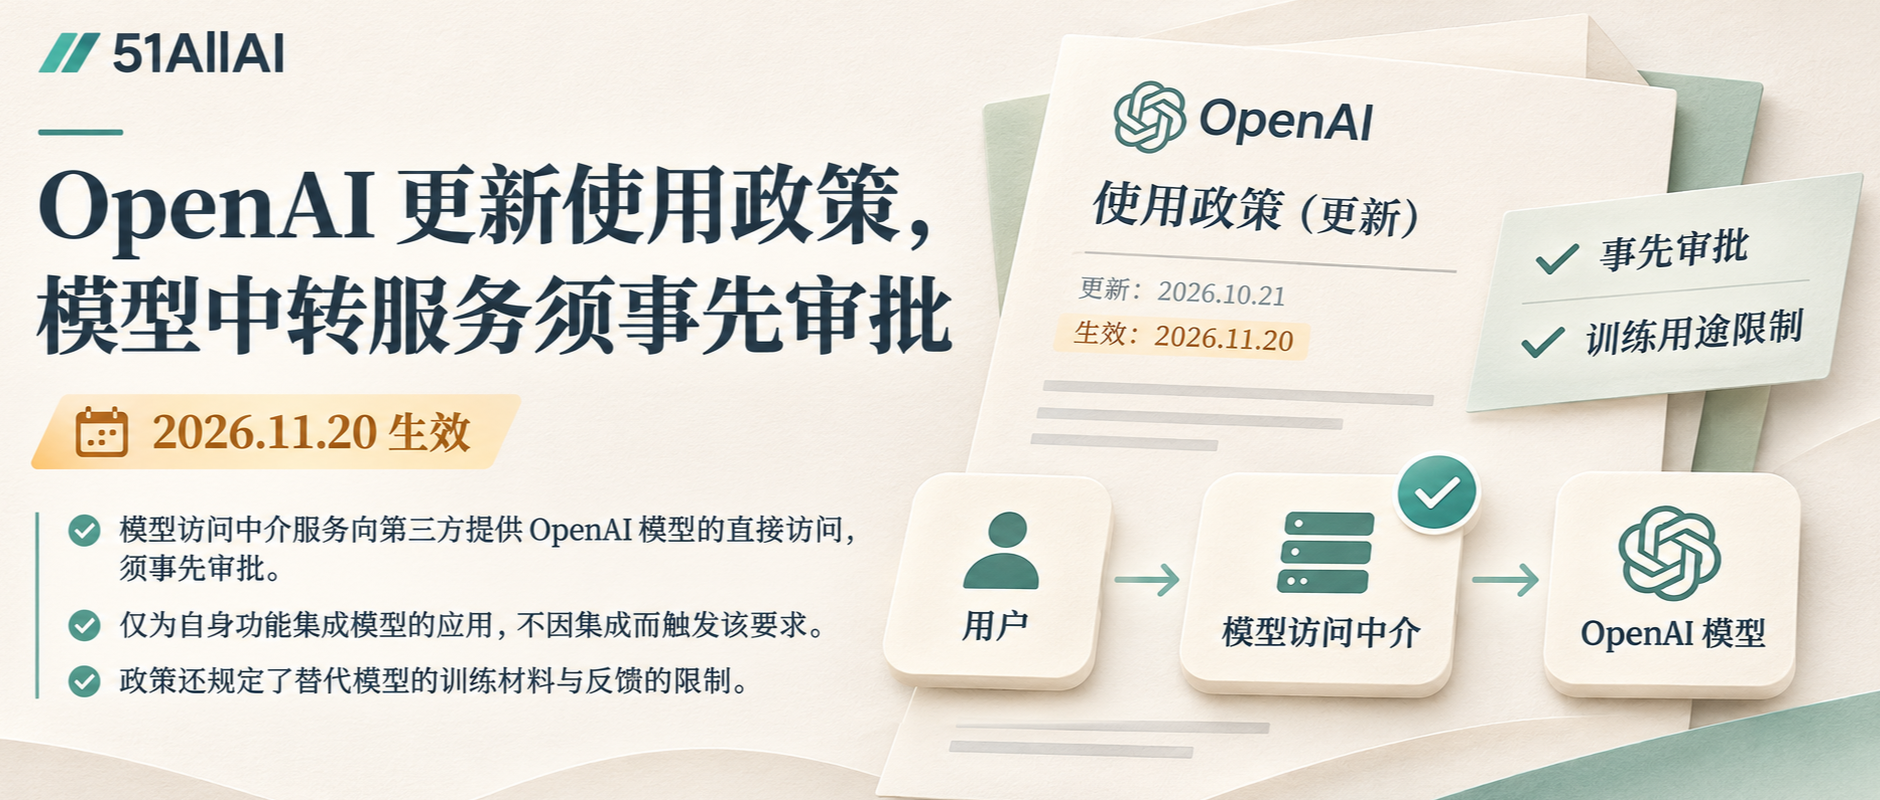
    <content type="html"><![CDATA[<blockquote><p>OpenAI 新版《使用政策》将于 2026 年 11 月 20 日生效，要求向第三方提供模型直接访问的中转服务事先获批，并细化替代模型训练材料与反馈的使用限制。普通应用接入模型功能，有不同的审批适用条件；个人用户还需核对现行的地区、付款与账号共享规则。<br><img src="https://images.51allai.com/blog/openai-usage-policy-model-access-cover_20261114_220830.png" alt="OpenAI 使用政策更新与模型中转服务事先审批示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="11-月-20-日起，提供模型直接访问须事先获批"><a href="#11-月-20-日起，提供模型直接访问须事先获批" class="headerlink" title="11 月 20 日起，提供模型直接访问须事先获批"></a>11 月 20 日起，提供模型直接访问须事先获批</h2><p>OpenAI 于 10 月 21 日更新<a href="https://openai.com/policies/usage-policies/">《使用政策》</a>，新版本将于 11 月 20 日生效。在此之前，旧版本继续适用；现有协议及其他适用条款仍然有效。</p><p>新版本要求：运营模型访问中介平台，或通过其他服务让第三方直接访问 OpenAI 模型，需要事先获得 OpenAI 审核与批准。这里的中介服务，可以理解为在用户与模型之间提供访问通道的服务。</p><p><strong>仅仅把 OpenAI 模型接入应用、用于支撑应用功能，不会因此触发这项审批要求。</strong> 开发者需要按实际业务模式区分，产品是在提供自己的应用功能，还是在向第三方提供模型的直接访问；同时核对已有协议中的明确许可，并遵守其他使用政策要求。</p><h2 id="替代模型的训练材料、打分与筛选均受限制"><a href="#替代模型的训练材料、打分与筛选均受限制" class="headerlink" title="替代模型的训练材料、打分与筛选均受限制"></a>替代模型的训练材料、打分与筛选均受限制</h2><p>新版政策限制使用 OpenAI 模型及其输出，为旨在替代 OpenAI 模型或服务的模型生成、准备、筛选或提供训练材料和训练信号。范围覆盖制作训练数据与任务、给样本打分或排序，以及筛选和验证训练数据。</p><p>这项限制也覆盖为他人准备材料、委托他人操作，以及把产品使用或评估中的输出随后用于上述训练。即使没有亲自训练最终模型，也在适用范围内。通过未经授权的访问、逆向工程或绕过防护提取受保护的推理内容，同样受到禁止。</p><p>在这些边界内，研究、软件开发、模型评估、基准测试和产品开发仍可使用 OpenAI 模型；适用协议明确准许的用途继续按协议执行。</p><p>限制竞争模型训练已有条款基础：2026 年 1 月 1 日生效的个人《使用条款》已禁止用输出开发与 OpenAI 竞争的模型。此次更新进一步列出了参与训练的数据制作、反馈和筛选环节。</p><h2 id="中国大陆及港澳的使用资格，按现行地区名单核对"><a href="#中国大陆及港澳的使用资格，按现行地区名单核对" class="headerlink" title="中国大陆及港澳的使用资格，按现行地区名单核对"></a>中国大陆及港澳的使用资格，按现行地区名单核对</h2><p>截至 11 月 14 日，ChatGPT 网页端、移动端及 OpenAI API 的支持地区名单均不包含中国大陆、香港和澳门，中国台湾在名单内。在名单以外地区访问服务，或向这些地区提供访问，可能导致账号被阻止访问或暂停。</p><p>付款也有地区要求。使用来自不支持地区的付款方式会被阻止使用服务；银行卡须由受支持地区的银行发行。核对订阅资格时，需要同时看实际使用地和发卡地区。</p><p>这些地区与付款条件已适用，不能把 11 月 20 日理解为它们统一开始执行的日期。跨平台使用者还可对照本站的 <a href="/posts/2026/11/claude-supported-regions-policy/">Claude 支持地区政策说明</a>，分别核对各家服务的规则。</p><h2 id="个人账号不能共用，本人多设备登录可以"><a href="#个人账号不能共用，本人多设备登录可以" class="headerlink" title="个人账号不能共用，本人多设备登录可以"></a>个人账号不能共用，本人多设备登录可以</h2><p>个人 OpenAI 账号供创建者本人使用，不能把登录凭证交给他人，或把账号开放给其他人使用。本人在多台设备上登录属于允许的使用方式，但仍受账号活动和订阅额度限制。</p><p>绕过安全过滤、内容限制或安全控制，以及违反条款的账号或 API 密钥共享，都可能导致限制或账号关闭。API 密钥是软件调用服务的访问凭证，应按适用条款管理。</p><p>处理方式包括警告、临时安全停用和永久关闭，具体以通知为准。收到警告不等于账号已经关闭；持续违规可能带来进一步限制。遇到停用或关闭，可按通知中的链接申请复核，操作入口可参阅 <a href="/posts/2026/11/chatgpt-account-deactivation-appeal/">ChatGPT 账号停用与申诉处理说明</a>。</p>]]></content>
    
    
    <summary type="html">OpenAI 新版使用政策将于 11 月 20 日生效，要求提供模型直接访问的中转服务事先获批，并细化替代模型训练限制。本文说明普通应用集成与中转服务的区别，以及 ChatGPT 和 API 的地区、付款与账号共享规则。</summary>


    <category term="行业观察" scheme="https://51allai.com/categories/%E8%A1%8C%E4%B8%9A%E8%A7%82%E5%AF%9F/"/>
    
    
    <category term="product-update" scheme="https://51allai.com/tags/product-update/"/>
    
    <category term="security" scheme="https://51allai.com/tags/security/"/>
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="chatgpt" scheme="https://51allai.com/tags/chatgpt/"/>
    
  </entry>
  
  <entry>
    <title>Google 发布 Gemini 4 Hydrogen，开放免费 API 与四档思考</title>
    <link href="https://51allai.com/posts/2026/11/google-gemini-4-hydrogen/"/>
    <id>https://51allai.com/posts/2026/11/google-gemini-4-hydrogen/</id>
    <published>2026-11-13T01:36:25.000Z</published>
    <updated>2026-11-13T01:36:25.000Z</updated>
    
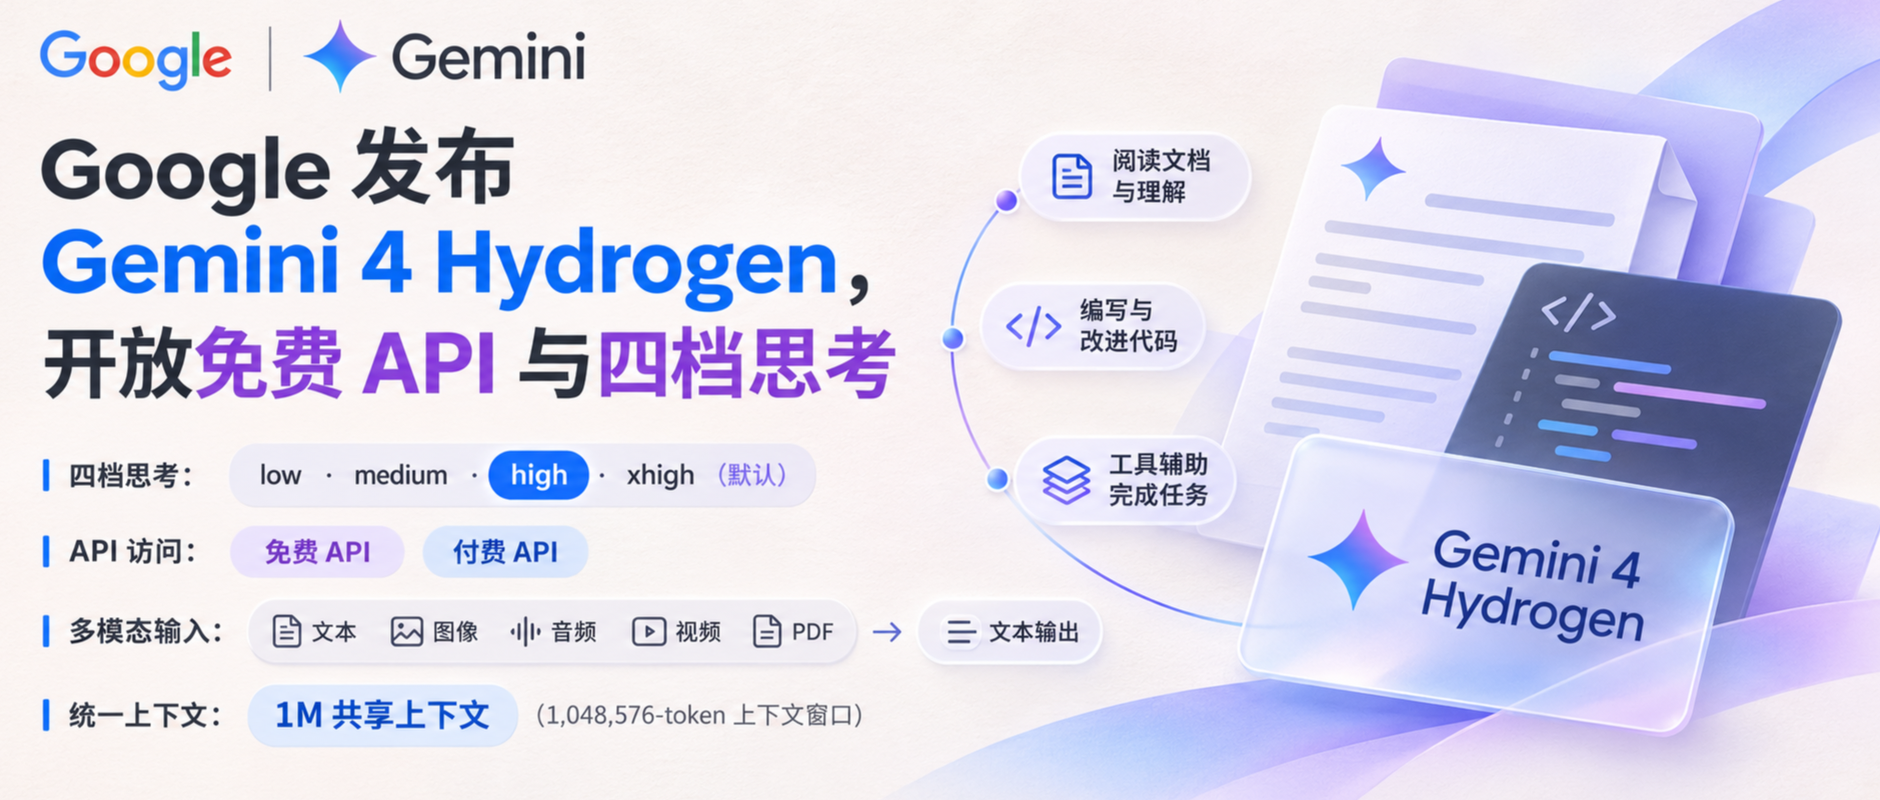
    <content type="html"><![CDATA[<blockquote><p>Google 于 11 月 12 日发布 Gemini 4 Hydrogen，面向日常编程、文档处理和工具调用任务，开放免费与付费 API。模型支持四档思考，输入、思考与输出共享百万 Token 容量；付费标准价为每百万输入 Token 1.50 美元、输出 Token 7.50 美元。<br><img src="https://images.51allai.com/blog/google-gemini-4-hydrogen-cover_20261113_094139.png" alt="Google Gemini 4 Hydrogen 免费 API 与四档思考主题图" fetchpriority="high" decoding="async"></p></blockquote><h2 id="Gemini-4-新增面向日常任务的型号"><a href="#Gemini-4-新增面向日常任务的型号" class="headerlink" title="Gemini 4 新增面向日常任务的型号"></a>Gemini 4 新增面向日常任务的型号</h2><p>Gemini 4 Hydrogen 是 Google 新推出的通用 AI 模型，可用于编写和调试代码、整理资料，以及按步骤调用工具完成任务。能够调用工具、连续推进工作的 AI 程序，通常称为智能体。</p><p>开发者使用的稳定模型标识为 <code>gemini-4-hydrogen</code>。它能接收文字、图片、视频、音频和 PDF，输出文字；可以读取图表和文档内容，也支持代码执行、文件搜索、函数调用与结构化输出。函数调用让模型连接外部工具，结构化输出则让结果按指定字段返回，方便软件继续处理。</p><p>Hydrogen 本身不直接生成图片或音频，也不支持 Live API 实时语音接口。理解音视频与生成音视频是不同能力，接入时需要按任务选择对应模型。</p><h2 id="免费用户能用，应用与-API-分别开放"><a href="#免费用户能用，应用与-API-分别开放" class="headerlink" title="免费用户能用，应用与 API 分别开放"></a>免费用户能用，应用与 API 分别开放</h2><p>普通用户可从 <a href="https://gemini.google.com/">Gemini 应用</a> 体验 Hydrogen。免费用户通过自动模型选择，在适合的提示词下获得 Hydrogen 响应；这与自行指定模型的使用方式不同。Google 搜索也开始向所有用户逐步推出 Hydrogen。</p><p>开发者可以在 <a href="https://aistudio.google.com/prompts/new_chat?model=gemini-4-hydrogen">Google AI Studio</a> 测试，或通过 Gemini API 接入自己的程序。API 同时提供免费档与付费档，免费档受速率和配额限制，支持 GenerateContent 与 Interactions 两种接口。</p><p>在 Antigravity 编程工具中，Hydrogen 向付费 Google AI Pro 和 Ultra 订阅用户逐步开放。应用订阅、Antigravity 使用额度和 API 调用费用分别计算，不能把订阅权益当成免费 API 额度。</p><h2 id="四档思考，默认从-high-开始"><a href="#四档思考，默认从-high-开始" class="headerlink" title="四档思考，默认从 high 开始"></a>四档思考，默认从 high 开始</h2><p>Hydrogen 支持 <code>low</code>、<code>medium</code>、<code>high</code> 和新增的 <code>xhigh</code> 四档思考，默认是 <code>high</code>。思考档位用于控制模型在回答前投入多少推理，影响响应时间与 Token 消耗。Token 是模型处理内容和计费时使用的单位，不等于汉字或英文单词。</p><p>快速聊天、分类和交互式网页原型，可以先测试 <code>low</code> 或 <code>medium</code>；复杂编程和多步任务可从默认 <code>high</code> 开始。需要更深推理时再尝试 <code>xhigh</code>，同时比较结果、耗时和用量，选择能满足任务要求的档位。</p><p>从 Gemini 3.8 Flash 迁移时，默认档位会从 <code>medium</code> 变为 <code>high</code>。沿用旧程序但不显式设置档位，推理用量可能随之变化。Hydrogen 不接受 <code>minimal</code>，传入会报错。</p><h2 id="百万容量由输入、思考和输出共同占用"><a href="#百万容量由输入、思考和输出共同占用" class="headerlink" title="百万容量由输入、思考和输出共同占用"></a>百万容量由输入、思考和输出共同占用</h2><p>Hydrogen 的统一上下文窗口为 <strong>1,048,576 Token</strong>，输入材料、思考过程和最终回答共享这份容量。放入接近上限的文档后，可供继续生成的空间会相应减少。</p><p>默认同步输出预算为 65,536 Token，包含思考和最终回答。需要超过这一预算时，可使用 Long decode，也就是分段继续生成。在 Interactions API 中，一种接入方式是同时设置 <code>background: true</code>，并把 <code>max_output_tokens</code> 提高到 65,536 以上，让服务端在后台续接。</p><p>只开启后台执行、保持默认输出上限，仍会在 65,536 Token 处停止。长输出的总量也受剩余上下文容量限制；“最高百万输出”不能理解为输入百万 Token 后，还能额外输出百万 Token。</p><h2 id="API-标准价为输入-1-50-美元、输出-7-50-美元"><a href="#API-标准价为输入-1-50-美元、输出-7-50-美元" class="headerlink" title="API 标准价为输入 1.50 美元、输出 7.50 美元"></a>API 标准价为输入 1.50 美元、输出 7.50 美元</h2><p>以下为付费 Gemini API 的模型价格，单位是美元／百万 Token。输出费用包含思考 Token。</p><table><thead><tr><th>调用方式</th><th align="right">输入</th><th align="right">输出，含思考</th></tr></thead><tbody><tr><td>Standard 标准调用</td><td align="right">1.50</td><td align="right">7.50</td></tr><tr><td>Batch 批量处理</td><td align="right">0.75</td><td align="right">3.75</td></tr></tbody></table><p>Standard 对整个百万上下文窗口使用统一单价。例如，一次任务使用 10 万个未缓存输入 Token，并产生 1 万个可计费输出 Token，模型费用为 <strong>0.225 美元</strong>；同样用量采用 Batch 为 0.1125 美元。这项计算不含搜索等工具费用，输出用量已包含思考。</p><p>隐式缓存命中的输入，Standard 单价为每百万 Token 0.075 美元。隐式缓存由服务自动识别可复用内容，Hydrogen 不支持开发者自行创建显式缓存。免费档内容可用于改进产品，标准付费档内容不用于改进产品，处理业务资料前应按所用档位核对数据条款。</p><h2 id="Antigravity-新增动态切换模型的-Orchestrator"><a href="#Antigravity-新增动态切换模型的-Orchestrator" class="headerlink" title="Antigravity 新增动态切换模型的 Orchestrator"></a>Antigravity 新增动态切换模型的 Orchestrator</h2><p>Antigravity 同步推出 Orchestrator，可在同一次任务中动态切换模型。例如，由 Carbon 分析依赖、制定计划，再交给 Hydrogen 修改代码、更新软件包和运行测试；遇到困难时，可以切回 Carbon 检查状态并调整计划。</p><p>Orchestrator 的开放范围与单独使用 Hydrogen 不同：Ultra 用户逐步获得 Carbon 和 Argon 两种 Orchestrator 选项，付费 Pro 用户获得 Argon 选项。需要了解 Carbon 的使用入口，可参阅 <a href="/posts/2026/11/google-gemini-4-carbon/">Gemini 4 Carbon 上线与 API 价格说明</a>。</p><p>已有 3.8 Flash 程序迁移时，除了更换模型名称，还应移除显式缓存字段以及 <code>temperature</code>、<code>top_p</code>、<code>top_k</code> 采样设置，检查共享上下文与输出预算。先用一组熟悉的任务比较思考档位和完整账单，再决定是否把批量处理或日常编程流程切换到 Hydrogen。</p>]]></content>
    
    
    <summary type="html">Google 发布 Gemini 4 Hydrogen，向开发者开放免费与付费 API，并在 Gemini 应用和搜索中逐步推出。本文梳理使用入口、四档思考、百万 Token 共享容量和长输出条件，以及 API 单价、迁移设置与 Antigravity 模型协作。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="google" scheme="https://51allai.com/tags/google/"/>
    
    <category term="gemini" scheme="https://51allai.com/tags/gemini/"/>
    
  </entry>
  
  <entry>
    <title>阿里发布 Qwen4-Max 预览版，支持百万上下文，Token Plan 限时两折</title>
    <link href="https://51allai.com/posts/2026/11/alibaba-qwen4-max-preview/"/>
    <id>https://51allai.com/posts/2026/11/alibaba-qwen4-max-preview/</id>
    <published>2026-11-11T13:38:45.000Z</published>
    <updated>2026-11-11T13:38:45.000Z</updated>
    
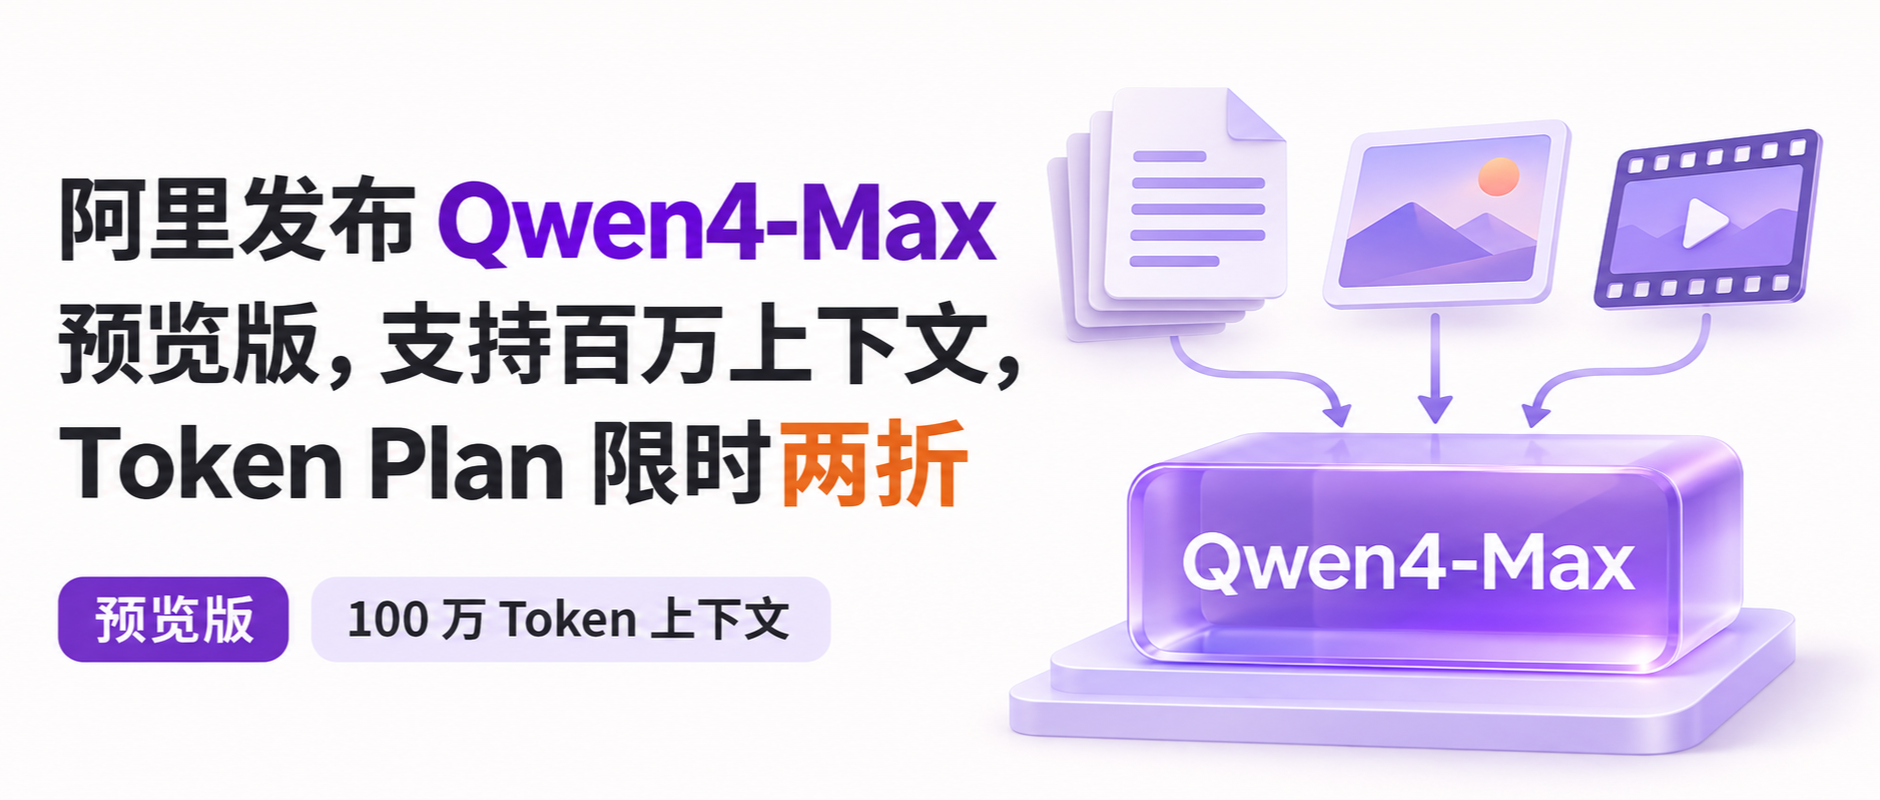
    <content type="html"><![CDATA[<blockquote><p>阿里于 11 月 11 日开放 Qwen4-Max 预览版，支持百万 Token 上下文和文本、图片、视频输入，API 通过 Token Plan 调用。预览期截至北京时间 11 月 25 日 24:00，期间模型保持不变，结束后下线；调用消耗的套餐 Credits 限时两折。<br><img src="https://images.51allai.com/blog/alibaba-qwen4-max-preview-cover_20261111_214311.png" alt="阿里 Qwen4-Max 预览版百万上下文与 Token Plan 主题图" fetchpriority="high" decoding="async"></p></blockquote><h2 id="百万上下文，支持图片和视频理解"><a href="#百万上下文，支持图片和视频理解" class="headerlink" title="百万上下文，支持图片和视频理解"></a>百万上下文，支持图片和视频理解</h2><p>Qwen4-Max 预览版是千问新一代旗舰多模态模型，可接收文字、图片和视频，并以文字回答。用户可以把文档、截图或视频与问题一起提交，用于材料分析、编程开发和办公任务。</p><p>它的上下文窗口为 <strong>100 万 Token</strong>。Token 是模型拆分、处理内容的基本单位；上下文容量决定一次任务能容纳多少材料和对话记录。站内此前介绍的 <a href="/posts/2026/08/qwen38-max-launch/">Qwen3.8-Max 也提供百万 Token 上下文</a>，因此容量本身不能作为新版本效果提升的依据。</p><p>模型支持工具调用和结构化输出。前者允许模型请求外部函数或联网搜索，后者能按约定的 JSON 格式返回结果，便于软件继续处理。需要查资料、读取工具结果再回答的多步任务，可以通过这些接口组织起来。</p><h2 id="API-仅通过-Token-Plan-开放，预览至-11-月-25-日"><a href="#API-仅通过-Token-Plan-开放，预览至-11-月-25-日" class="headerlink" title="API 仅通过 Token Plan 开放，预览至 11 月 25 日"></a>API 仅通过 Token Plan 开放，预览至 11 月 25 日</h2><p>本次开放的模型标识为 <code>qwen4-max-preview</code>，API 仅支持 Token Plan，不支持按量计费。Token Plan 是按套餐订阅、用 Credits 抵扣消耗的服务；Credits 是套餐额度单位，与 Token 数量分别计量。</p><p>预览期为 <strong>2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00（北京时间）</strong>。这段时间内模型不做变更，预览结束后下线。计划接入的用户应把试用、评估和后续切换安排在这个期限内。</p><p>个人版限定在编程和智能体工具中交互式使用，不能用于自动化脚本、自定义应用后端或非交互式批量调用。个人版的输入及生成内容会用于服务改进与模型优化，订阅前应确认材料是否适合该数据使用条款。</p><h2 id="两折抵扣-Credits，新客套餐优惠另算"><a href="#两折抵扣-Credits，新客套餐优惠另算" class="headerlink" title="两折抵扣 Credits，新客套餐优惠另算"></a>两折抵扣 Credits，新客套餐优惠另算</h2><p>Qwen4-Max 预览版的限时两折作用于 <strong>Credits 消耗</strong>。个人版每晚 22:00 至次日 08:00 再享四折，叠加后为标准消耗的 8%，即 0.8 折。例如，一项原本消耗 1,000 Credits 的调用，活动期间消耗 200 Credits，夜间叠加后为 80 Credits。</p><p>套餐购买价是另一项费用。个人版 Lite 套餐为 39 元&#x2F;月，含 20,000 Credits；从未购买过个人版的账号，可享 19.5 元&#x2F;月的新客限时价，优惠有效期至 11 月 30 日 23:59:59（北京时间）。预算应分别核算订阅支出与调用消耗，实际 Credits 用量可在控制台查看。</p><h2 id="使用专属密钥接入，检查思考与回答的共同预算"><a href="#使用专属密钥接入，检查思考与回答的共同预算" class="headerlink" title="使用专属密钥接入，检查思考与回答的共同预算"></a>使用专属密钥接入，检查思考与回答的共同预算</h2><p>从 <a href="https://www.aliyun.com/benefit/scene/tokenplan">Token Plan 产品页</a>订阅后，在控制台生成套餐专属 API Key，再把密钥、接口地址和模型名称配置到支持自定义模型的 AI 工具中。个人版密钥以 <code>sk-sp-</code> 开头，只在生成时完整显示一次，应及时保存。</p><table><thead><tr><th>配置项</th><th>值</th></tr></thead><tbody><tr><td>模型标识</td><td><code>qwen4-max-preview</code></td></tr><tr><td>OpenAI 兼容 Base URL</td><td><code>https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1</code></td></tr><tr><td>Anthropic 兼容 Base URL</td><td><code>https://token-plan.cn-beijing.maas.aliyuncs.com/apps/anthropic</code></td></tr><tr><td>身份凭据</td><td>Token Plan 套餐专属 API Key</td></tr></tbody></table><p>模型默认开启思考，也就是在给出回答前先进行推理。最大输出预算为 <strong>393,216 Token，思考和最终回答共同占用</strong>。在 OpenAI Chat Completions 接口中，<code>max_tokens</code> 与 <code>max_completion_tokens</code> 均限制这两部分的总量。</p><p>例如，把 <code>max_tokens</code> 设为 8,000，思考过程就会占用其中一部分，不能按“可得到 8,000 Token 的最终回答”规划输出。沿用旧配置迁移时，应为思考和回答一起预留预算，先用一份熟悉的材料检查是否出现提前截断，再调整上限。</p>]]></content>
    
    
    <summary type="html">阿里发布 Qwen4-Max 预览版，支持百万 Token 上下文和文本、图片、视频输入，API 通过 Token Plan 开放。本文梳理预览期限、套餐与 Credits 折扣、接入地址及输出预算变化，说明个人版的使用范围，帮助用户安排试用与迁移。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="alibaba" scheme="https://51allai.com/tags/alibaba/"/>
    
    <category term="qwen" scheme="https://51allai.com/tags/qwen/"/>
    
  </entry>
  
  <entry>
    <title>百度发布文心 5.5 Flash Preview，支持百万上下文，API 限时五折</title>
    <link href="https://51allai.com/posts/2026/11/baidu-ernie-55-flash-preview/"/>
    <id>https://51allai.com/posts/2026/11/baidu-ernie-55-flash-preview/</id>
    <published>2026-11-11T08:52:28.000Z</published>
    <updated>2026-11-11T08:52:28.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>百度于 11 月 11 日发布文心 5.5 Flash Preview，支持最长 100 万 Token 上下文，开发者可通过千帆 API 调用。API 限时五折，折后每百万 Token 高峰输入 1 元、输出 4 元，空闲时段分别为 0.5 元、2 元。<br><img src="https://images.51allai.com/blog/baidu-ernie-55-flash-preview-cover_20261111_170554.png" alt="百度文心 5.5 Flash Preview 百万上下文与 API 五折主题图" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从-Base-模型到可调用的-Preview-版本"><a href="#从-Base-模型到可调用的-Preview-版本" class="headerlink" title="从 Base 模型到可调用的 Preview 版本"></a>从 Base 模型到可调用的 Preview 版本</h2><p>文心 5.5 Flash Preview（ERNIE 5.5 Flash Preview）是百度的新基础模型，也是此前文心 5.5 Flash Base 的首个后训练版本。后训练是在基础训练之后，继续训练模型按指令回答问题、使用工具和完成任务。</p><p>这个版本总参数量为 2800 亿，每处理一个 Token 激活其中 140 亿参数。Token 是模型处理文字的计量单位，不等于汉字数。Preview 属于后训练过程中的中间版本，后续仍会继续优化。</p><p>它是纯文本模型。编程、3D 建模和视频创作通过编写代码、调用外部工具与编排素材完成。例如，3D 工作流可以连接 Blender 或 CAD 软件，由代码控制建模；视频工作流则可以结合图片、视频生成工具及剪辑程序。接入这些场景时，需要同时准备工具运行环境和相应素材。</p><h2 id="百万上下文适合放入更长的材料"><a href="#百万上下文适合放入更长的材料" class="headerlink" title="百万上下文适合放入更长的材料"></a>百万上下文适合放入更长的材料</h2><p>文心 5.5 Flash Preview 支持 1M，也就是约 100 万 Token 的上下文。上下文指一次任务中模型能够处理的内容范围，长文档、代码和多轮对话都需要占用容量。</p><p>对开发者而言，这提供了把较长资料放在同一请求中处理的空间，例如围绕一组项目文件提问，或对多份材料做交叉整理。准备输入时仍要计算 Token 用量，并为生成内容留出空间。</p><p>千帆将它列入文本生成和深度思考模型列表。深度思考模式的最大输出长度包含思考过程和最终回答，设置输出预算时需要同时考虑两部分。</p><h2 id="API-五折后，高峰输入每百万-Token-1-元"><a href="#API-五折后，高峰输入每百万-Token-1-元" class="headerlink" title="API 五折后，高峰输入每百万 Token 1 元"></a>API 五折后，高峰输入每百万 Token 1 元</h2><p>API 按高峰和空闲时段分别计费：高峰为 8:00–22:00，空闲为 22:00–次日 8:00。以下均为人民币／百万 Token，活动价已经打过五折。</p><table><thead><tr><th>计费项目</th><th align="right">高峰原价</th><th align="right">高峰活动价</th><th align="right">空闲原价</th><th align="right">空闲活动价</th></tr></thead><tbody><tr><td>输入，未命中缓存</td><td align="right">2 元</td><td align="right">1 元</td><td align="right">1 元</td><td align="right">0.5 元</td></tr><tr><td>输入，命中缓存</td><td align="right">0.2 元</td><td align="right">0.1 元</td><td align="right">0.1 元</td><td align="right">0.05 元</td></tr><tr><td>输出</td><td align="right">8 元</td><td align="right">4 元</td><td align="right">4 元</td><td align="right">2 元</td></tr></tbody></table><p>例如，一次请求使用 10 万个未命中缓存的输入 Token，产生 1 万个可计费输出 Token，按活动价计算，高峰费用为 <strong>0.14 元</strong>，空闲时段为 <strong>0.07 元</strong>。这是模型 Token 费用，外部工具和运行环境的费用另算。</p><p>缓存命中指平台复用已经处理过的输入片段，命中部分按更低的输入单价计算。预算应把未命中输入、命中输入和输出分别统计。</p><p>对可以延后执行的资料整理、离线评测等任务，空闲单价是高峰活动价的一半。站内此前整理过 <a href="/posts/2026/08/deepseek-api-weekend-off-peak-pricing/">DeepSeek API 的周末与峰谷计费规则</a>，接入多个平台时应分别设置任务时段。</p><h2 id="在千帆选择模型，沿用-OpenAI-兼容接口"><a href="#在千帆选择模型，沿用-OpenAI-兼容接口" class="headerlink" title="在千帆选择模型，沿用 OpenAI 兼容接口"></a>在千帆选择模型，沿用 OpenAI 兼容接口</h2><p>开发者可从<a href="https://console.bce.baidu.com/qianfan/modelcenter/model/buildIn/detail/am-abe18d298d70">千帆模型详情页</a>进入。通过 API 接入时，先在千帆控制台创建具有相应服务权限的 API Key，再配置以下参数：</p><table><thead><tr><th>配置项</th><th>值</th></tr></thead><tbody><tr><td>模型标识 <code>model</code></td><td><code>ernie-5.5-flash-preview</code></td></tr><tr><td>OpenAI SDK 的 <code>base_url</code></td><td><code>https://qianfan.baidubce.com/v2</code></td></tr><tr><td>HTTP 对话请求地址</td><td><code>https://qianfan.baidubce.com/v2/chat/completions</code></td></tr><tr><td>身份验证</td><td>使用千帆 API Key，HTTP 请求头为 <code>Authorization: Bearer &lt;API Key&gt;</code></td></tr></tbody></table><p>已有 OpenAI SDK 项目的开发者，可以调整密钥、服务地址和模型名称进行接入。千帆列出的默认限额为每分钟 60 次请求、每分钟 100 万 Token；前者限制请求次数，后者限制处理量，批量提交长材料时两项都要考虑。</p><p>试用时可以先选一份熟悉的文档或一个小型代码任务，检查结果是否满足要求，再记录实际输入、输出用量和工具开销，估算扩大使用后的成本。</p>]]></content>
    
    
    <summary type="html">百度于 11 月 11 日发布文心 5.5 Flash Preview，支持百万 Token 上下文，API 已上线千帆。本文梳理纯文本与工具协作的能力边界、接入方式、峰谷时段和五折活动价，并用一笔调用示例说明实际费用，帮助开发者评估长文档与代码任务的接入成本。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="baidu" scheme="https://51allai.com/tags/baidu/"/>
    
    <category term="ernie" scheme="https://51allai.com/tags/ernie/"/>
    
  </entry>
  
  <entry>
    <title>Google 正式上线 Gemini 4 Carbon，API 首发价与 Argon 相同</title>
    <link href="https://51allai.com/posts/2026/11/google-gemini-4-carbon/"/>
    <id>https://51allai.com/posts/2026/11/google-gemini-4-carbon/</id>
    <published>2026-11-11T01:28:44.000Z</published>
    <updated>2026-11-11T01:28:44.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>Google 于 11 月 10 日扩大开放 Gemini 4 Carbon：开发者可使用付费 API，Google AI Ultra 用户可逐步在 Gemini 应用、Antigravity 和搜索 AI Mode 中体验。API 首发标准价为每百万输入 Token 2 美元、输出 10 美元，与 Argon 相同，优惠截至 11 月 30 日。<br><img src="https://images.51allai.com/blog/google-gemini-4-carbon-cover_20261111_093325.png" alt="Gemini 4 Carbon 正式上线与复杂任务协作主题图" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从网络安全试用扩大到开发者和订阅用户"><a href="#从网络安全试用扩大到开发者和订阅用户" class="headerlink" title="从网络安全试用扩大到开发者和订阅用户"></a>从网络安全试用扩大到开发者和订阅用户</h2><p>Gemini 4 Carbon 是 Google 的推理模型，基于 Gemini 4 Argon，面向复杂软件工程、资料分析、科学推理和需要连续执行多个步骤的智能体任务。智能体指能调用工具、按步骤推进工作的 AI 程序。</p><p>这次上线的变化是开放范围。Carbon 两周前先通过 Fairwind 计划向部分网络安全防御人员提供访问，11 月 10 日开始面向更多开发者、企业和个人订阅用户开放。</p><p>不同用户的入口如下：</p><table><thead><tr><th>使用方式</th><th>入口与条件</th></tr></thead><tbody><tr><td>开发者测试与接入</td><td>在 <a href="https://aistudio.google.com/prompts/new_chat?model=gemini-4-carbon">Google AI Studio</a> 测试，或使用付费 Gemini API；Carbon 不提供 API 免费档</td></tr><tr><td>个人日常使用</td><td>向 Google AI Ultra 订阅用户逐步推出 <a href="https://gemini.google.com/">Gemini 应用</a> 和搜索 AI Mode 体验</td></tr><tr><td>编程与项目协作</td><td>Ultra 用户可在 <a href="https://antigravity.google/">Google Antigravity</a> 的 App、CLI 和 IDE 扩展中使用 Carbon</td></tr><tr><td>企业使用</td><td>通过 Gemini for business 接入</td></tr><tr><td>专门的网络安全防御能力</td><td>通过 Fairwind 计划申请 Carbon for cyber，按审核条件逐步开放</td></tr></tbody></table><p>API 付费调用与应用订阅是不同渠道；Fairwind 的专门网络安全访问也有单独的申请条件。</p><h2 id="多模态输入、文字输出，百万容量由输入和生成共享"><a href="#多模态输入、文字输出，百万容量由输入和生成共享" class="headerlink" title="多模态输入、文字输出，百万容量由输入和生成共享"></a>多模态输入、文字输出，百万容量由输入和生成共享</h2><p>API 中的稳定模型名称为 <code>gemini-4-carbon</code>。它可接收文字、图片、视频、音频和 PDF，输出文字，适合在同一任务里处理文档、图表和代码。它支持代码执行、函数调用、文件搜索和结构化输出；函数调用用于连接外部工具，结构化输出用于按规定字段返回数据。</p><p>Carbon 的统一上下文窗口为 1,048,576 Token。Token 是模型处理内容的计量单位，输入材料、思考过程和最终输出共同占用这份容量。因此，“百万上下文”不能理解为放入百万 Token 的材料后，还能额外生成同样长度的回答。</p><p>默认同步输出上限为 65,536 Token。更长的生成需要使用 Long decode，也就是分段继续生成：在 Interactions API 中开启后台执行，并把 <code>max_output_tokens</code> 设为 65,536 以上。仅开启后台执行而不提高输出上限，仍会在 64K Token 处停止。长输出还需为输入和思考过程预留容量。</p><p>思考深度有 <code>low</code>、<code>medium</code>、<code>high</code> 三档，默认是 <code>medium</code>。输出上限包含思考与回答两部分，接入时要为最终回答留出空间。</p><h2 id="首发单价与-Argon-相同，12-月-1-日起翻倍"><a href="#首发单价与-Argon-相同，12-月-1-日起翻倍" class="headerlink" title="首发单价与 Argon 相同，12 月 1 日起翻倍"></a>首发单价与 Argon 相同，12 月 1 日起翻倍</h2><p>以下是 Gemini API 的 Standard 标准调用价格，单位为美元／百万 Token。输出费用包含模型思考消耗的 Token。</p><table><thead><tr><th>计费项目</th><th align="right">截至 2026 年 11 月 30 日</th><th align="right">自 2026 年 12 月 1 日起</th></tr></thead><tbody><tr><td>输入</td><td align="right">2</td><td align="right">4</td></tr><tr><td>输出，含思考</td><td align="right">10</td><td align="right">20</td></tr></tbody></table><p>例如，一次任务使用 10 万个未缓存输入 Token，并产生 1 万个可计费输出 Token，首发期的模型费用为 0.30 美元，12 月 1 日起为 0.60 美元。这里的输出用量已包含思考 Token，计算不含搜索等工具费用。</p><p>不需要即时返回的批量任务可使用 Batch：首发期输入、输出分别为 1 美元、5 美元／百万 Token，12 月 1 日起调整为 2 美元、10 美元。</p><p>Carbon 与 <a href="/posts/2026/10/google-gemini-4-argon/">Gemini 4 Argon</a> 的每 Token 单价相同，但单次任务的账单还取决于实际用量。对复杂问题，Carbon 会使用更多思考 Token，不能把相同单价理解成每项任务费用相同。评估接入成本时，应统计包含思考的完整用量。</p><h2 id="Antigravity-同步预览多智能体协作"><a href="#Antigravity-同步预览多智能体协作" class="headerlink" title="Antigravity 同步预览多智能体协作"></a>Antigravity 同步预览多智能体协作</h2><p>Antigravity 同时推出 <code>/swarm</code> 预览功能，可把一项需求交给多个智能体协作：协调者分配工作，执行者在各自独立的代码工作区中修改文件，验证者运行测试并检查改动。用户可以在共享看板里查看进展，并进入具体智能体的执行记录。</p><p>团队中的智能体可以分别指定模型，例如让 Carbon 负责架构设计和审查，让其他模型处理具体实现。<code>/swarm</code> 从 11 月 10 日起在 Antigravity App 和 CLI 中逐步开放预览；Carbon 本身也可用于 IDE 扩展。多智能体并行会比普通单次对话更快消耗额度。</p><p>准备试用的开发者，可以先在 AI Studio 用自己的文档或代码测试 Carbon，再比较实际耗时、结果和 Token 用量；需要多个智能体协作推进项目时，再使用 Antigravity 的 <code>/swarm</code> 预览。</p>]]></content>
    
    
    <summary type="html">Google 于 11 月 10 日正式上线 Gemini 4 Carbon，开放付费 API，并向 Ultra 订阅用户逐步推出应用体验。本文梳理使用入口、与 Argon 相同的限时单价、思考 Token 计费、百万上下文条件，以及 Antigravity 的多智能体协作预览。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="google" scheme="https://51allai.com/tags/google/"/>
    
    <category term="gemini" scheme="https://51allai.com/tags/gemini/"/>
    
  </entry>
  
  <entry>
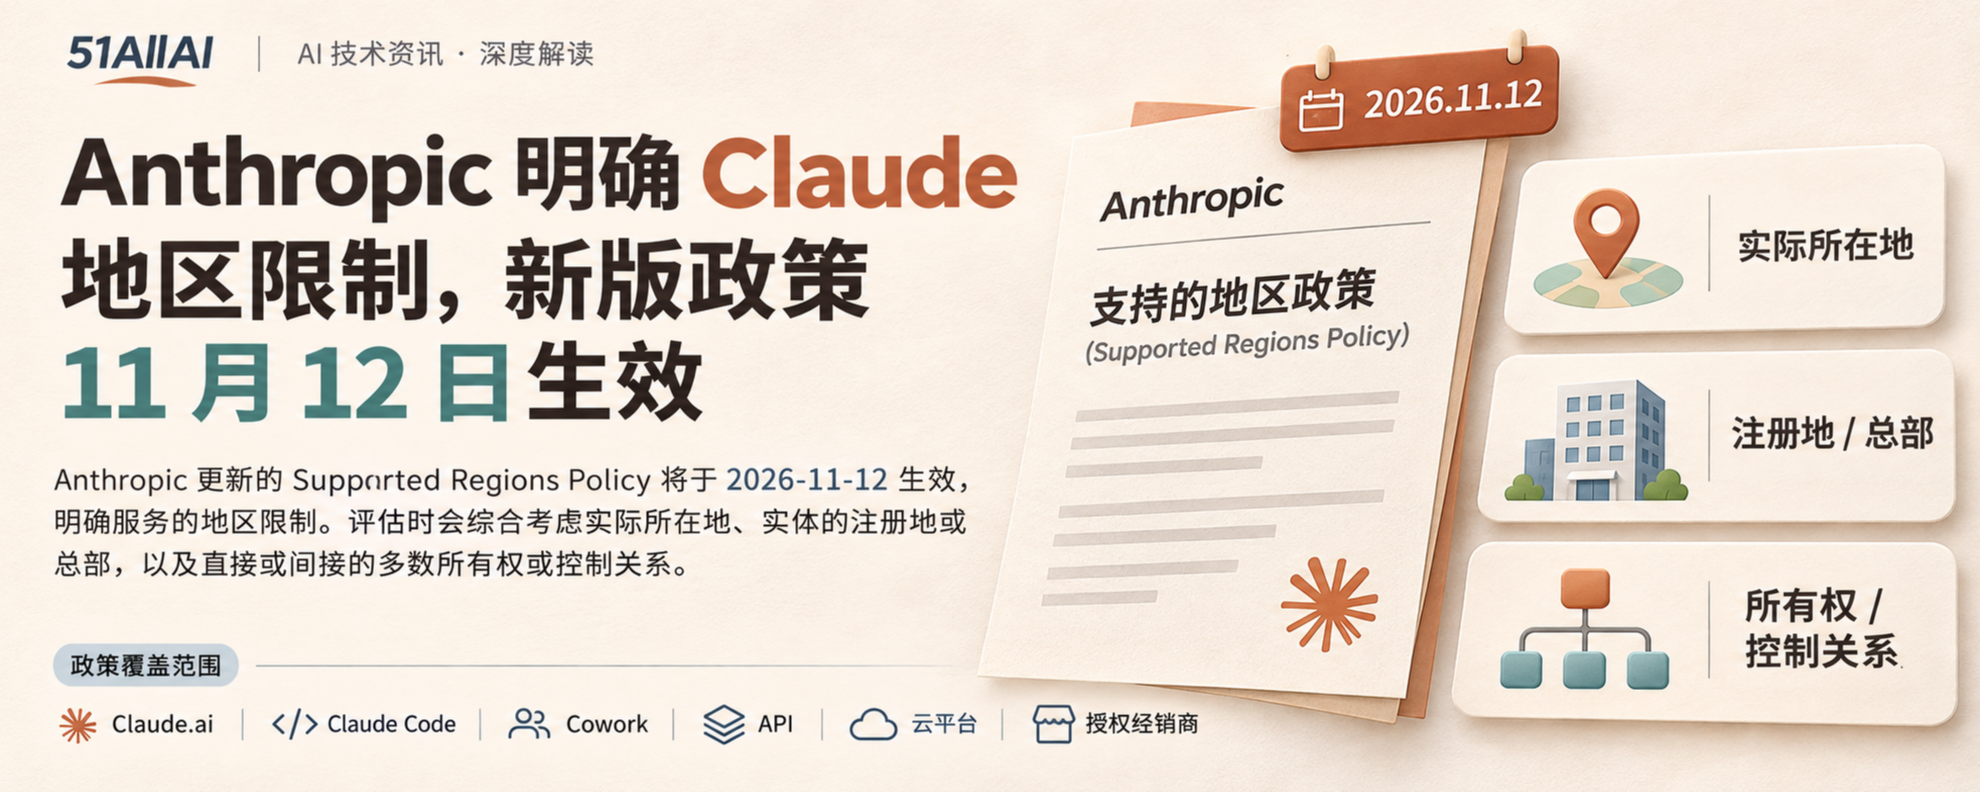
    <title>Anthropic 明确 Claude 地区限制，新版政策 11 月 12 日生效</title>
    <link href="https://51allai.com/posts/2026/11/claude-supported-regions-policy/"/>
    <id>https://51allai.com/posts/2026/11/claude-supported-regions-policy/</id>
    <published>2026-11-10T15:50:30.000Z</published>
    <updated>2026-11-10T15:50:30.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>Anthropic 新版 Claude 支持地区政策将于 2026 年 11 月 12 日生效，明确限制实际位于不支持地区的个人、在这些地区注册或设立总部的实体，以及由这些地区的个人或实体直接、间接多数持有或控制的企业。范围覆盖 Claude.ai、Claude Code、Cowork、API，以及云平台和授权经销商提供的 Claude 模型。<br><img src="https://images.51allai.com/blog/claude-supported-regions-policy-cover_20261110_235605.png" alt="Claude 支持地区政策的所在地、企业主体与控制关系三类限制示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="11-月-12-日生效，海外控制关系限制已有先例"><a href="#11-月-12-日生效，海外控制关系限制已有先例" class="headerlink" title="11 月 12 日生效，海外控制关系限制已有先例"></a>11 月 12 日生效，海外控制关系限制已有先例</h2><p>Claude 是 Anthropic 提供的 AI 助手，可通过网页、应用、编程工具和开发者接口使用。新版<a href="https://www.anthropic.com/legal/supported-regions">支持地区政策</a>将于 2026 年 11 月 12 日生效，政策更新说明已于 10 月 8 日发布。</p><p>涉及海外子公司的限制可以追溯到 2025 年 9 月 4 日。当时的调整已禁止受不支持地区控制的公司或组织使用服务，包括由总部位于不支持地区的公司直接或间接持股超过 50% 的实体。</p><p>此次条款进一步列出个人所在地、企业注册地或总部、所有权与控制关系，并明确相关用户和员工也在适用范围内。对跨境团队来说，只核对采购公司的注册地，无法完成使用资格判断。</p><h2 id="三类限制分别看所在地、企业主体和控制关系"><a href="#三类限制分别看所在地、企业主体和控制关系" class="headerlink" title="三类限制分别看所在地、企业主体和控制关系"></a>三类限制分别看所在地、企业主体和控制关系</h2><p>新版政策列出三类不受支持的使用情形：</p><table><thead><tr><th>判断维度</th><th>条款覆盖的情形</th><th>对使用者的影响</th></tr></thead><tbody><tr><td>个人实际所在地</td><td>使用时身处不支持地区，包括原本受支持实体的用户和员工</td><td>就职于受支持地区的公司，也需满足实际使用地要求</td></tr><tr><td>实体注册地或总部</td><td>实体在不支持地区注册，或总部位于不支持地区</td><td>相关用户和员工即使身处受支持地区，仍在限制范围内</td></tr><tr><td>所有权或控制关系</td><td>实体被不支持地区的个人或实体直接、间接多数持有或控制</td><td>在受支持地区设立公司，仍需核对其所有权和控制关系，限制也覆盖相关用户和员工</td></tr></tbody></table><p>“实体”包括公司、组织等主体。“间接持有”涉及通过其他公司形成的持股关系；“控制”与“多数持有”在条款中并列，核对时需要同时考虑。</p><p>例如，员工人在美国，但其所属公司在不支持地区注册或设立总部，仍属于第二类情形。海外子公司若由不支持地区的个人或实体多数持有或控制，则属于第三类情形。</p><h2 id="Claude-Code、API-和云平台渠道均在范围内"><a href="#Claude-Code、API-和云平台渠道均在范围内" class="headerlink" title="Claude Code、API 和云平台渠道均在范围内"></a>Claude Code、API 和云平台渠道均在范围内</h2><p>政策覆盖的入口包括 Claude.ai、Claude Code 和 Cowork 等应用、API 与开发者平台，以及通过云平台和授权经销商提供的 Claude 模型。</p><p>因此，企业通过云平台采购 Claude，也需要核对实际用户和企业主体是否符合地区政策。云服务的部署区域、采购主体的注册地，以及员工的实际所在地，是不同的核对项。</p><p>配套的使用政策还覆盖集成 Claude 的产品或服务的终端用户，即通过其他应用向 Claude 提交内容的人。对提供 AI 功能的开发者而言，检查范围包含实际使用这项功能的用户。</p><h2 id="中国大陆及港澳未列入，新加坡和台湾在名单中"><a href="#中国大陆及港澳未列入，新加坡和台湾在名单中" class="headerlink" title="中国大陆及港澳未列入，新加坡和台湾在名单中"></a>中国大陆及港澳未列入，新加坡和台湾在名单中</h2><p>截至 11 月 10 日，新版支持名单未列入中国大陆、香港和澳门；新加坡和台湾在名单中。名单内地区的公司和用户，仍需满足上述实体、控制关系与实际所在地要求。</p><p>订阅付款与服务使用资格也要分别核对。此前<a href="/posts/2026/10/claude-china-billing-unionpay/">Claude 付款页出现中国选项和银联卡标识</a>，涉及的是账单填写与银行卡识别，判断能否使用仍应回到支持地区政策。</p><p>个人用户可先核对实际使用地；企业团队则需一并核对签约实体、总部所在地、直接与间接所有权、控制关系，以及员工和终端用户的使用地。使用政策列出的违规处理方式包括警告、限流、限制、暂停或终止访问。</p>]]></content>
    
    
    <summary type="html">Anthropic 新版 Claude 支持地区政策将于 11 月 12 日生效，明确实际所在地、实体注册地或总部、所有权与控制关系三类限制。本文梳理中国大陆及港澳的支持状态、海外子公司与员工适用范围，以及云平台渠道的要求。</summary>


    <category term="行业观察" scheme="https://51allai.com/categories/%E8%A1%8C%E4%B8%9A%E8%A7%82%E5%AF%9F/"/>
    
    
    <category term="anthropic" scheme="https://51allai.com/tags/anthropic/"/>
    
    <category term="claude" scheme="https://51allai.com/tags/claude/"/>
    
    <category term="claude-code" scheme="https://51allai.com/tags/claude-code/"/>
    
  </entry>
  
  <entry>
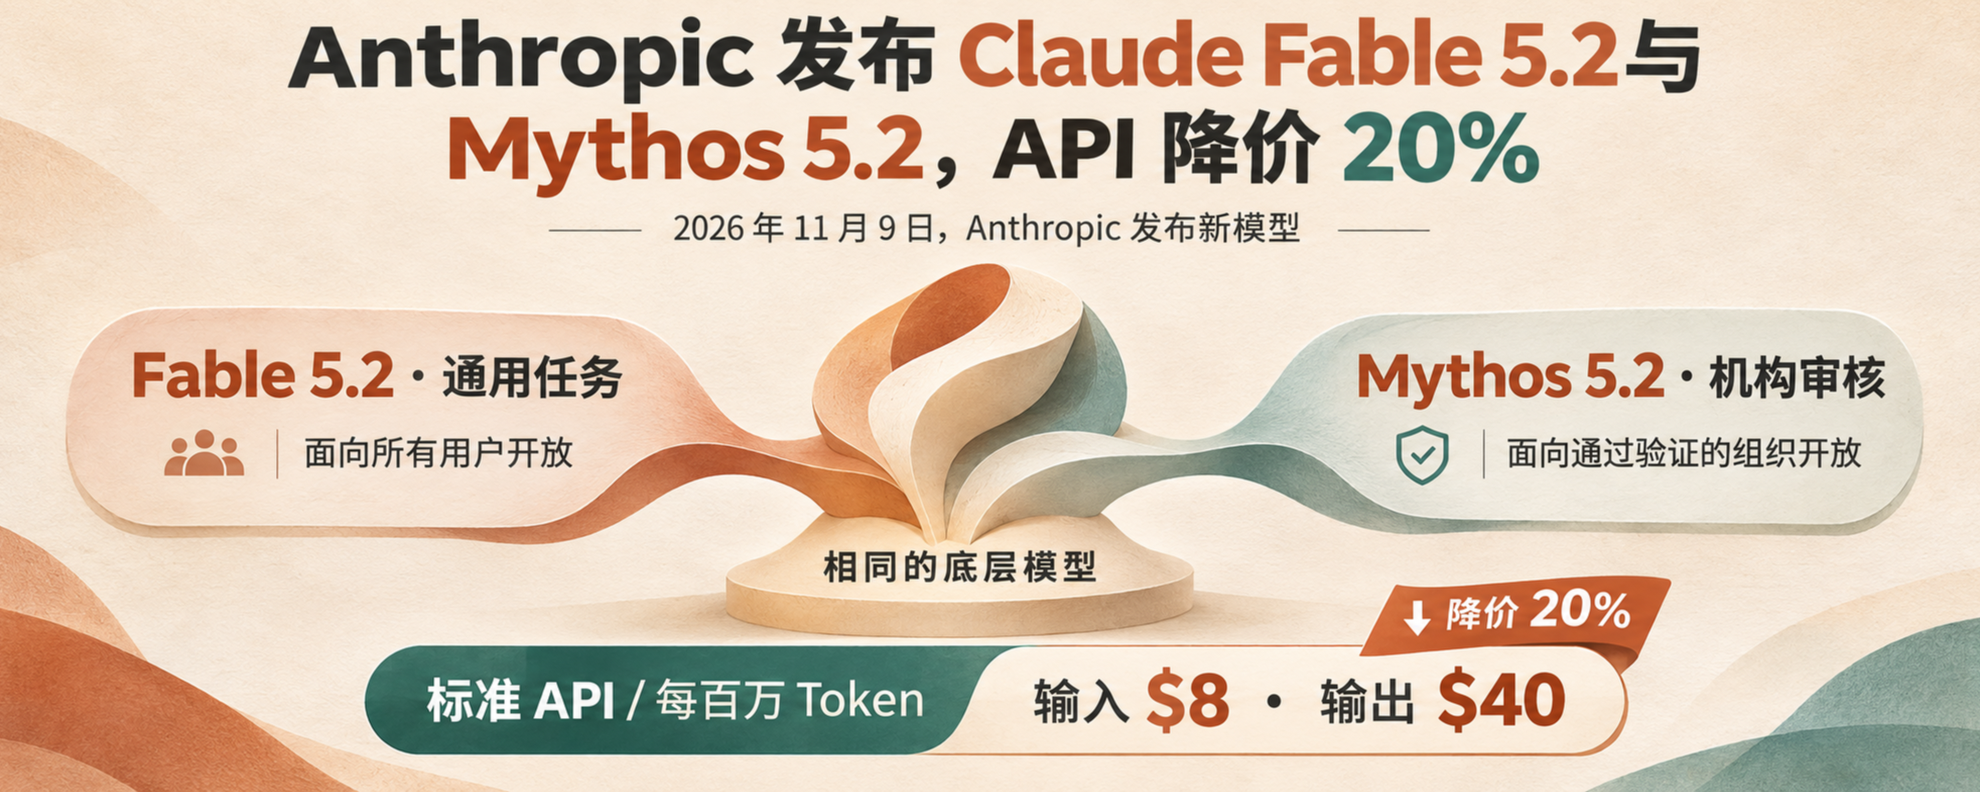
    <title>Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2，API 降价 20%</title>
    <link href="https://51allai.com/posts/2026/11/claude-fable-mythos-5-2/"/>
    <id>https://51allai.com/posts/2026/11/claude-fable-mythos-5-2/</id>
    <published>2026-11-10T01:07:38.000Z</published>
    <updated>2026-11-10T01:07:38.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>Anthropic 于 11 月 9 日发布 Claude Fable 5.2 与 Mythos 5.2。两者使用同一底层模型，标准 API 价格降至每百万输入 Token 8 美元、输出 40 美元，较 5.1 下调 20%。Fable 面向通用用户，Mythos 需要机构审核；Pro 和 Team 标准席位获得一周订阅内 Fable 访问。<br><img src="https://images.51allai.com/blog/claude-fable-mythos-5-2-cover_20261110_091329.png" alt="Claude Fable 5.2 与 Mythos 5.2 发布及 API 降价封面" fetchpriority="high" decoding="async"></p></blockquote><h2 id="同一底层模型，访问范围不同"><a href="#同一底层模型，访问范围不同" class="headerlink" title="同一底层模型，访问范围不同"></a>同一底层模型，访问范围不同</h2><p>Claude Fable 5.2 和 Claude Mythos 5.2 是面向复杂推理与长任务的模型，可用于代码开发、多步研究和文档分析。两者共享底层模型，区别在于安全防护和访问权限。</p><p>Fable 5.2 带有网络安全和生物研究领域的防滥用机制，适合通用任务。Mythos 5.2 面向通过审核的机构，网络安全专业人士和生命科学研究者可申请对应的验证计划。购买普通 Claude 订阅并不直接获得 Mythos 访问资格。</p><p>两款模型均支持文本和图片输入、文本输出，提供 100 万 Token 上下文和最多 128K Token 输出。Token 是模型处理文字的计量单位；上下文窗口决定一次请求能容纳多少材料，与最终回答的最大长度是两项限制。</p><h2 id="标准-API-降价-20-，快速模式另行计费"><a href="#标准-API-降价-20-，快速模式另行计费" class="headerlink" title="标准 API 降价 20%，快速模式另行计费"></a>标准 API 降价 20%，快速模式另行计费</h2><p>两款 5.2 模型采用相同的 API 定价。以下为 Claude API 的美元价格，单位均为每百万 Token：</p><table><thead><tr><th>计费项</th><th align="right">Fable &#x2F; Mythos 5.1</th><th align="right">Fable &#x2F; Mythos 5.2</th></tr></thead><tbody><tr><td>标准输入</td><td align="right">10</td><td align="right">8</td></tr><tr><td>标准输出</td><td align="right">50</td><td align="right">40</td></tr><tr><td>缓存读取</td><td align="right">0.25</td><td align="right">0.20</td></tr><tr><td>5 分钟缓存写入</td><td align="right">12.50</td><td align="right">10</td></tr><tr><td>1 小时缓存写入</td><td align="right">20</td><td align="right">16</td></tr></tbody></table><p>例如，一项任务累计使用 100 万个普通输入 Token、10 万个输出 Token，按标准价格计算，费用由 15 美元降至 12 美元，节省 3 美元。这个计算固定了 Token 用量，不含缓存、工具和其他附加计费。</p><p>与<a href="/posts/2026/09/claude-fable-5-1-mythos-5-1/">5.1 主要下调缓存读取价格</a>相比，本次标准输入和输出也降价。提示词缓存用于复用重复的项目背景、文档等内容，写入与读取分别计费。</p><p>Fable 5.2 与 Mythos 5.2 还提供快速模式，输入为 16 美元、输出为 80 美元，均为标准模式的两倍。开启前需单独核算预算；各云平台的区域与部署计费应按对应价目表计算。</p><h2 id="Pro-与-Team-标准席位获得一周订阅内访问"><a href="#Pro-与-Team-标准席位获得一周订阅内访问" class="headerlink" title="Pro 与 Team 标准席位获得一周订阅内访问"></a>Pro 与 Team 标准席位获得一周订阅内访问</h2><p>发布活动从 2026 年 11 月 9 日开始，到太平洋时间 11 月 16 日 23:59 结束，即北京时间 11 月 17 日 15:59。</p><p>活动期间，Pro 用户和 Team 标准席位可把每周额度最多 50% 用于 Fable 系列，覆盖 Fable 5.2、5.1 和 5。用户需要在模型选择器中主动选择，默认模型保持原样。活动结束或用完这部分额度后，已启用用量积分的账户改由积分计费。</p><p>符合条件的付费账户还可获得 Fable 用量重置。重置恢复已经消耗的额度，不提高原有上限；可在「设置 → 用量」查看并使用。获得重置要求账户或组织在太平洋时间 11 月 9 日上午 10 点前已建立付费账单，团队席位持有人还需在该时间前加入组织。</p><h2 id="开发者接入需检查对话历史与数据保留"><a href="#开发者接入需检查对话历史与数据保留" class="headerlink" title="开发者接入需检查对话历史与数据保留"></a>开发者接入需检查对话历史与数据保留</h2><p>开发者可通过 Claude API 调用 <code>claude-fable-5-2</code>，获批机构使用 <code>claude-mythos-5-2</code>。Fable 5.2 也已在 Amazon Bedrock、Claude Platform on AWS、Google Cloud 和 Microsoft Foundry 上线。Bedrock 用户可进入控制台的 Test → Playground，选择 Fable 5.2 试用。</p><p>从 5.1 迁移时，需要检查自己是否会修改对话历史。5.2 对所有账户执行思考块前缀校验：模型返回的思考块记录其推理状态，与此前的系统提示、工具列表及对话内容绑定。自行修改这些内容后再传回原思考块，会触发 400 错误。由 Claude Code、claude.ai 或 Claude Agent SDK 管理历史的用户无需自行处理这项校验。</p><p>两款模型要求保留数据 30 天用于安全监测。已有零数据保留安排的企业，需要获得明确授权或调整对应工作空间的数据保留设置，再接入这两个模型。</p>]]></content>
    
    
    <summary type="html">Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2，标准 API 输入、输出价格均下调 20%，保留 100 万 Token 上下文。本文梳理两个版本的访问区别、快速模式价格、Pro 与 Team 限时活动，以及开发者迁移要求。</summary>


    <category term="大模型" scheme="https://51allai.com/categories/%E5%A4%A7%E6%A8%A1%E5%9E%8B/"/>
    
    
    <category term="anthropic" scheme="https://51allai.com/tags/anthropic/"/>
    
    <category term="claude-fable" scheme="https://51allai.com/tags/claude-fable/"/>
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
  </entry>
  
  <entry>
    <title>字节跳动发布 Seedream 5.5，新增原生透明素材生成</title>
    <link href="https://51allai.com/posts/2026/11/seedream-55-transparent-editing/"/>
    <id>https://51allai.com/posts/2026/11/seedream-55-transparent-editing/</id>
    <published>2026-11-09T10:19:24.000Z</published>
    <updated>2026-11-09T10:19:24.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>11 月 9 日，字节跳动发布图像创作模型 Seedream 5.5，新增原生透明及半透明素材生成，并支持围绕同一张图连续进行局部编辑。模型正陆续在即梦、豆包、豆包工作与火山方舟上线，创作者可用文字或参考图制作素材，再用于排版与合成。<br><img src="https://images.51allai.com/blog/seedream-55-transparent-editing-cover_20261109_182442.png" alt="Seedream 5.5 原生透明素材生成与多轮局部编辑示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="透明素材可以单独排版、组合"><a href="#透明素材可以单独排版、组合" class="headerlink" title="透明素材可以单独排版、组合"></a>透明素材可以单独排版、组合</h2><p>Seedream 5.5 是用于生成和编辑图片的多模态模型，可以结合文字与参考图完成创作。此次新增的原生 RGBA 输出，让生成结果可以直接包含透明或半透明区域。</p><p>RGBA 中的 RGB 记录颜色，A 是 Alpha 通道，用来记录每个像素的透明程度。对做贴纸、艺术字或角色素材的人来说，可以先生成独立元素，再把它放进不同的海报或背景里。</p><p>使用时，应把“透明”写成明确的交付要求。例如，下面是一组可替换主体的原创提示词，示例本身不代表实测结果：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">生成一张橘猫抱着蓝色咖啡杯的卡通贴纸。</span><br><span class="line">完整保留猫耳、尾巴、胡须和杯柄，主体居中，四周留出余量。</span><br><span class="line">猫和杯子以外的区域透明，输出带 Alpha 通道的图片。</span><br></pre></td></tr></table></figure><p>下载后，把文件分别放到浅色和深色背景上，检查边缘是否有杂色、胡须是否完整。棋盘格只是编辑器常用的透明预览方式；确认文件含有透明通道，才能把它作为透明素材使用。</p><h2 id="围绕同一张图逐轮修改"><a href="#围绕同一张图逐轮修改" class="headerlink" title="围绕同一张图逐轮修改"></a>围绕同一张图逐轮修改</h2><p>Seedream 5.5 支持多轮局部编辑，包括调整人物造型、替换桌面物件，以及增减房间里的家具和装饰。创作流程可以是先生成一张底图，再以前一轮结果为输入，逐项调整。</p><p>例如，已经有一张室内照片，只想替换靠窗的椅子，可以这样写：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">把靠窗的椅子换成深蓝色布艺扶手椅。</span><br><span class="line">保持椅子的摆放位置与朝向，让大小、透视和地面阴影适配房间。</span><br><span class="line">保留窗户、桌子、地板、墙面和其他家具，不改变画面裁切范围。</span><br></pre></td></tr></table></figure><p>下一轮再单独调整椅子的颜色或材质，便于判断哪一步引入了不需要的变化。每轮保存结果，并对照底图检查主体、背景、色彩和文字；必须保留的区域也要纳入验收。</p><p>海报文字和局部改图的需求写法，可以结合站内的<a href="/posts/2026/11/gpt-image-26-prompting-guide/">图像提示词指南：准确文字、参考图分工与保留项</a>使用，具体参数则应按所选模型设置。</p><h2 id="从哪个入口选择-Seedream-5-5"><a href="#从哪个入口选择-Seedream-5-5" class="headerlink" title="从哪个入口选择 Seedream 5.5"></a>从哪个入口选择 Seedream 5.5</h2><p>Seedream 5.5 正在陆续上线，可按下面的路径寻找模型：</p><table><thead><tr><th>平台</th><th>模型选择路径</th></tr></thead><tbody><tr><td>即梦网页版</td><td>创作 → 生成或画布 → Seedream 5.5</td></tr><tr><td>豆包 App、网页版</td><td>图像生成 → 选择模型 Seedream 5.5</td></tr><tr><td>豆包工作</td><td>技能 → Seedream5.5</td></tr><tr><td>火山方舟体验中心</td><td>视觉模型 → 图片生成 → Doubao-Seedream-5.5</td></tr></tbody></table><p>第一次使用时，可以先拿一张已有图片做单项修改，或生成一张透明贴纸，检查导出的文件是否符合后续设计需要。处理海报和信息图时，把文案逐字写清楚，交付前核对标题、小字和标签关系；保留提示词、输入图与成品，方便继续编辑。</p>]]></content>
    
    
    <summary type="html">字节跳动发布 Seedream 5.5，新增原生透明及半透明素材生成，支持多轮局部编辑。本文解释 RGBA 素材的用途，提供透明贴纸与局部改图的中文提示词，并整理即梦、豆包、豆包工作和火山方舟体验中心的模型选择路径。</summary>


    <category term="多模态" scheme="https://51allai.com/categories/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    
    
    <category term="model-release" scheme="https://51allai.com/tags/model-release/"/>
    
    <category term="image-generation" scheme="https://51allai.com/tags/image-generation/"/>
    
    <category term="bytedance" scheme="https://51allai.com/tags/bytedance/"/>
    
    <category term="seedream" scheme="https://51allai.com/tags/seedream/"/>
    
  </entry>
  
  <entry>
    <title>用好 GPT Image 2.6 官方提示指南：从文字排版到局部编辑</title>
    <link href="https://51allai.com/posts/2026/11/gpt-image-26-prompting-guide/"/>
    <id>https://51allai.com/posts/2026/11/gpt-image-26-prompting-guide/</id>
    <published>2026-11-09T02:17:29.000Z</published>
    <updated>2026-11-09T02:17:29.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>GPT Image 2.6 的提示词可以直接写成自然语言：说明图片用途、主体、构图和风格；需要文字时列出准确文案，编辑时分开写改动项与保留项。本文整理可复制的中文示例，并说明两款模型的选择、API 参数和批注编辑方式。<br><img src="https://images.51allai.com/blog/gpt-image-26-prompting-guide-cover_20261109_102144.png" alt="GPT Image 2.6 提示指南中的文字排版与局部编辑示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="先说要做什么图，再写画面要求"><a href="#先说要做什么图，再写画面要求" class="headerlink" title="先说要做什么图，再写画面要求"></a>先说要做什么图，再写画面要求</h2><p>GPT Image 2.6 是可以根据文字和参考图片生成、编辑图片的模型。写提示词时，先确定成品用途：商品照片、活动海报、文章封面，还是讲解流程的信息图。接着描述主体、位置、光线、颜色和必须保留的细节。</p><p>提示词不必套特殊格式。短句、完整段落、分项说明都能表达需求；内容多时，按“用途、主体、构图、风格、约束”分段，便于检查有没有遗漏。</p><p>下面是便于替换使用的原创中文示例，示例本身不代表实测结果：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">用途：制作一张咖啡店周末活动海报，竖版 3:4。</span><br><span class="line">主体：一只白色陶瓷拿铁杯，杯口能看见拉花，放在浅木色桌面上。</span><br><span class="line">构图：杯子放在下半部，上半部留给标题，杯子和标题不要重叠。</span><br><span class="line">风格：自然窗光，暖米色背景，保留陶瓷和木纹的质感。</span><br><span class="line">文字：顶部写“周末来杯咖啡”，只出现一次；下方写“慢一点，也很好”。</span><br><span class="line">排版：标题用深棕色粗体，副标题用较小字号，保证手机上可读。</span><br><span class="line">约束：不添加价格、日期或其他活动信息。</span><br></pre></td></tr></table></figure><p>“有高级感”很难说明你需要哪种画面。浅木桌面、自然窗光、深棕色标题，都是能在结果中逐项检查的要求。涉及人物时，也应说明取景范围、视线和动作，例如“全身入画，双脚完整可见，低头看手中的书”。</p><h2 id="需要准确文字，就写出原文、位置和次数"><a href="#需要准确文字，就写出原文、位置和次数" class="headerlink" title="需要准确文字，就写出原文、位置和次数"></a>需要准确文字，就写出原文、位置和次数</h2><p>海报、封面和商品包装常常需要文字。把文案放在引号里，说明它放在哪里、出现几次、使用什么字体和颜色。遇到生僻词或品牌名，可以补充逐字拼写。</p><p>得到图片后，逐字核对标题和小字，也要检查是否重复出现。图像生成仍可能出现文字不清楚或位置偏移，提示词中的要求需要在成品上验收。</p><p>如果构图已经满意，只需调整标题，可以把上一张结果作为编辑输入：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">只调整标题“周末来杯咖啡”的排版：字号稍大，改为深棕色粗体。</span><br><span class="line">标题文字和出现次数保持不变。</span><br><span class="line">保留杯子、拉花、桌面、背景、光线和副标题，不移动其他元素。</span><br></pre></td></tr></table></figure><p>每轮只提出一项改动，再检查结果。连续编辑时，重复写出必须保留的细节，能让每轮要求更明确。</p><h2 id="局部编辑要同时列出改动项和保留项"><a href="#局部编辑要同时列出改动项和保留项" class="headerlink" title="局部编辑要同时列出改动项和保留项"></a>局部编辑要同时列出改动项和保留项</h2><p>给房间换家具、给产品改色时，写明对象和目标状态，再列出周围哪些内容必须保留。例如，上传一张桌上有花瓶的照片后，可以这样要求：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">只把桌上的条纹花瓶改成纯钴蓝色陶瓷。</span><br><span class="line">保留花瓶的形状、大小、位置、瓶中的花枝，以及桌面阴影。</span><br><span class="line">相机角度、室内光线、桌椅和背景保持不变。</span><br></pre></td></tr></table></figure><p>使用 API 做圈选编辑时，可以提交独立的 <code>markup</code> 批注图层，也就是用圈线或草图指明修改对象的透明 PNG：</p><ul><li>原图作为第一张输入图片，批注图层与它的像素宽高一致。</li><li>批注图层必须含透明像素，不要把圈线和原图压平成同一张图片。</li><li>把图层传给 <code>markup</code>，提示词中解释圈线的含义，并要求成品去掉圈线。</li><li><code>markup</code> 只作用于第一张输入图，后续图片用作参考；同一请求不要同时传 <code>mask</code> 蒙版。</li></ul><p>这些是图片编辑 API 的请求要求。普通文字提示词负责说明改什么，图层负责指出位置。</p><p>编辑结果仍要检查未要求改动的区域。某块区域如果必须与原图逐像素一致，应在后期把通过检查的修改区域合成回原图，不能只依靠提示词保留。</p><h2 id="多张参考图，要给每张图分配用途"><a href="#多张参考图，要给每张图分配用途" class="headerlink" title="多张参考图，要给每张图分配用途"></a>多张参考图，要给每张图分配用途</h2><p>把场景、人物、服装或风格参考一起上传时，用编号说明每张图片负责什么，以及哪些元素需要组合。不要让“参考这几张”承担全部说明。</p><p>例如，准备一张房间照片和一张椅子照片：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">图 1 提供房间、拍摄角度和光线；图 2 提供椅子的外形与材质。</span><br><span class="line">用图 2 的椅子替换图 1 中靠窗的椅子，保留图 2 椅背和椅腿的形状。</span><br><span class="line">让新椅子的透视、大小和接触地面的阴影适配图 1。</span><br><span class="line">保留图 1 的窗户、桌子、地板和其他家具。</span><br></pre></td></tr></table></figure><p>做系列角色图时，也可以先建立角色参考，再换场景或姿势。每次都重复角色的服装、比例和外貌特征，并检查多张成品是否一致。</p><h2 id="API-中分开调整-quality-与-complexity"><a href="#API-中分开调整-quality-与-complexity" class="headerlink" title="API 中分开调整 quality 与 complexity"></a>API 中分开调整 quality 与 complexity</h2><p>GPT Image 2.6 提供 Flare 和 Sunburst 两款模型。选择时可以从任务需求开始：</p><table><thead><tr><th>使用需求</th><th>起始测试模型</th></tr></thead><tbody><tr><td>优先考虑响应时间、需要频繁迭代</td><td><code>gpt-image-2.6-flare</code></td></tr><tr><td>对细节、布局或编辑准确性要求较高</td><td><code>gpt-image-2.6-sunburst</code></td></tr></tbody></table><p>比较两款模型时，保持提示词、参考图、尺寸和质量设置相同，再检查输出和等待时间。模型选择建议不代表每个任务都会得到相同结果。</p><p><code>quality</code> 与 <code>complexity</code> 也需要分开设置：</p><table><thead><tr><th>参数</th><th>控制什么</th><th>调整方法</th></tr></thead><tbody><tr><td><code>quality</code></td><td>渲染的视觉细节，例如纹理、小字号文字</td><td>布局正确但细节不够时，保持复杂度不变，比较更高质量档位</td></tr><tr><td><code>complexity</code></td><td>渲染前的规划程度</td><td>局部改动可从 <code>low</code> 开始；复杂布局再比较更高档位</td></tr></tbody></table><p><code>complexity</code> 支持 <code>low</code>、<code>medium</code>、<code>high</code>，省略时两款模型都使用 <code>high</code>。更高复杂度可能增加等待时间，也可能带来额外改动。<code>quality</code> 则支持 <code>auto</code>、<code>low</code>、<code>medium</code>、<code>high</code>、<code>xhigh</code>、<code>max</code>。</p><p>这些字段要放进 API 请求中。图片尺寸由 <code>size</code> 设置，透明背景由 <code>background</code> 设置；在提示词里写期望的比例和外观时，也应让请求参数与之对应。2.6 图片编辑请求应省略 <code>input_fidelity</code>。</p><p>关于生成入口、GIF、SVG 和费用，可继续查看<a href="/posts/2026/11/chatgpt-images-26-gif-reference/">Images 2.6 的功能与 API 价格介绍</a>。</p><h2 id="保存成品前，按用途验收"><a href="#保存成品前，按用途验收" class="headerlink" title="保存成品前，按用途验收"></a>保存成品前，按用途验收</h2><p>文章封面要缩小到实际展示尺寸检查文字；人物图要对照参考检查外貌；产品图要检查形状、标签和材质。信息图还要核对标签之间的关系，不能只看画面是否整齐。</p><p>需要透明背景时，检查导出文件的透明通道，也就是文件中记录每个像素透明程度的数据。画面看起来像棋盘格，并不等于文件真的透明。</p><p>先保留一组有代表性的提示词、参考图和成品。之后更换模型或参数时，每轮只改变一个条件，记录可用结果的比例、等待时间和实际费用，再决定是否用于后续制作。</p>]]></content>
    
    
    <summary type="html">GPT Image 2.6 官方提示指南把生图要求拆成主体、构图、风格与约束。本文提供海报文字、局部改色和多图参考的中文提示词示例，解释 Flare、Sunburst 的选择，以及 quality、complexity 和批注图层的用法。</summary>


    <category term="多模态" scheme="https://51allai.com/categories/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="image-generation" scheme="https://51allai.com/tags/image-generation/"/>
    
  </entry>
  
  <entry>
    <title>ChatGPT 用户集中反馈账号停用，未收到邮件也可联系支持</title>
    <link href="https://51allai.com/posts/2026/11/chatgpt-account-deactivation-appeal/"/>
    <id>https://51allai.com/posts/2026/11/chatgpt-account-deactivation-appeal/</id>
    <published>2026-11-07T15:47:23.000Z</published>
    <updated>2026-11-07T15:47:23.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>11 月 7 日，ChatGPT 用户集中反馈账号突然无法登录，涉及 Plus 和团队账号，部分反馈者称未收到通知邮件。遇到这类情况，应先区分账号停用与普通登录报错：收到关闭通知可走邮件中的申诉入口，未收到邮件也可以通过帮助中心联系支持。<br><img src="https://images.51allai.com/blog/exec-8c4d25d9-6d5f-4d34-97f9-d56564a85181_20261107_235441.png" alt="ChatGPT 账号停用反馈与申诉处理示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="多位用户反馈账号突然无法使用"><a href="#多位用户反馈账号突然无法使用" class="headerlink" title="多位用户反馈账号突然无法使用"></a>多位用户反馈账号突然无法使用</h2><p>11 月 7 日，多位用户在开发者社区集中反馈，ChatGPT 账号突然无法登录。有人称自己的两个团队账号和一个土耳其区 Plus 账号同时无法使用；同一讨论中，也有用户反馈没有收到邮件，登录时才发现账号已无法访问。</p><p>对遇到问题的用户，先保存页面上的完整错误信息和收到的账号通知，再按提示选择处理渠道。</p><h2 id="先看报错，区分账号关闭与登录故障"><a href="#先看报错，区分账号关闭与登录故障" class="headerlink" title="先看报错，区分账号关闭与登录故障"></a>先看报错，区分账号关闭与登录故障</h2><p>账号关闭、临时安全停用和普通登录错误，需要采用不同的处理方式。</p><table><thead><tr><th>遇到的情况</th><th>对应处理方式</th></tr></thead><tbody><tr><td>收到永久关闭账号的通知</td><td>使用通知邮件中的申诉链接请求复核</td></tr><tr><td>无法访问账号，但没有收到关闭邮件</td><td>通过帮助中心联系支持团队</td></tr><tr><td>收到临时安全停用提示</td><td>查看提示中的停用安排；临时停用结束后，若没有其他账号限制，可重新登录</td></tr><tr><td>只出现 “Something went wrong” 或 “Oops” 等普通错误</td><td>先检查服务状态，再尝试无痕窗口、清理缓存或更换浏览器</td></tr></tbody></table><p>还要确认登录的是原来的账号。用 Google、Microsoft 或 Apple 注册的用户，应选用对应的登录方式；使用 Apple 隐藏邮箱注册时，账号可能绑定的是 Apple 转发邮箱。换用其他邮箱登录，可能进入另一个账号，无法看到原来的订阅和记录。</p><h2 id="未收到邮件，也有支持渠道"><a href="#未收到邮件，也有支持渠道" class="headerlink" title="未收到邮件，也有支持渠道"></a>未收到邮件，也有支持渠道</h2><p>收到账号关闭邮件的用户，可以直接使用邮件中的申诉链接。无法访问那封邮件时，可使用账号关闭申诉表单；没有收到关闭邮件、但已经失去访问权限的用户，可打开 <code>help.openai.com</code> 联系支持团队。</p><p>提交时，写明账号用途、问题发生时间、完整报错，以及认为账号关闭有误的理由。如能取得用户 ID 和组织 ID，也一并提供。报错中出现 <code>Request ID</code> 时，应完整复制；它是用于定位请求的编号，字母、数字和连字符都要保留。无法复制时，可附上清晰截图。</p><p>如怀疑账号被他人访问，还应说明异常发生的时间范围，以及已采取的保护措施，例如修改密码、更换可能泄露的 API 密钥。API 密钥是供软件调用服务的访问凭证。</p><p><strong>提交申诉不保证账号恢复。</strong> 支持材料应围绕自己的账号、实际使用情况和具体报错整理。</p><h2 id="API-充值失败另查支付状态"><a href="#API-充值失败另查支付状态" class="headerlink" title="API 充值失败另查支付状态"></a>API 充值失败另查支付状态</h2><p>同一时期，部分美国商业万事达卡出现支付被拒的问题，可能影响 API 自动充值和单次余额购买。预付余额耗尽后，API 请求也可能失败。</p><p>遇到这类支付失败，可按支付提示添加其他发卡机构的卡，并重新尝试购买余额。向支持团队报告不认识的扣款时，可提供扣款日期、金额和卡号后四位，<strong>不要提供完整卡号或安全码</strong>。</p><p>需要继续查找 ChatGPT 与 Codex 的产品、订阅变化，可查看本站的 <a href="/topics/openai/">OpenAI 专题</a>。</p>]]></content>
    
    
    <summary type="html">ChatGPT 用户于 11 月 7 日集中反馈账号停用，部分反馈者称未收到通知邮件。本文说明账号关闭、临时停用与普通登录报错的处理区别，梳理申诉入口，以及提交完整报错、Request ID 和账号资料的方法。</summary>


    <category term="行业观察" scheme="https://51allai.com/categories/%E8%A1%8C%E4%B8%9A%E8%A7%82%E5%AF%9F/"/>
    
    
    <category term="security" scheme="https://51allai.com/tags/security/"/>
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="chatgpt" scheme="https://51allai.com/tags/chatgpt/"/>
    
  </entry>
  
  <entry>
    <title>OpenAI 发布 ChatGPT Images 2.6，新增 GIF 与参考照片复用</title>
    <link href="https://51allai.com/posts/2026/11/chatgpt-images-26-gif-reference/"/>
    <id>https://51allai.com/posts/2026/11/chatgpt-images-26-gif-reference/</id>
    <published>2026-11-05T01:31:51.000Z</published>
    <updated>2026-11-05T01:31:51.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>OpenAI 于 11 月 4 日发布 ChatGPT Images 2.6，在 ChatGPT 和 Codex 各订阅档位推出。ChatGPT 正逐步开放 GIF 生成，并支持保存参考照片供后续对话调用；开发者可使用 Flare、Sunburst 两款 API 模型，标准 Token 单价与 2.5 相同。<br><img src="https://images.51allai.com/blog/chatgpt-images-26-gif-reference-cover_20261105_093645.png" alt="ChatGPT Images 2.6 GIF 动图生成与参考照片复用示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从静态图片生成循环-GIF"><a href="#从静态图片生成循环-GIF" class="headerlink" title="从静态图片生成循环 GIF"></a>从静态图片生成循环 GIF</h2><p>ChatGPT Images 是 ChatGPT 中创建和修改图片的功能。2.6 加入 GIF 动图创作：输入文字描述，或上传一张静态图片，就能要求把指定主体做成循环动画。GIF 是能够连续播放多帧画面的图片格式，常用于表情包、角色动作和产品展示。</p><p>例如，可以上传一张宠物照片，要求“让它抬起前爪打招呼，结尾回到起始姿势，生成循环 GIF”。生成后可在对话中继续描述修改，也能打开动图调整播放速度、下载或分享。</p><p>这项功能正在 ChatGPT 中逐步开放。它支持修改 ChatGPT 自己创建的 GIF，<strong>不能编辑用户上传的现成动画 GIF</strong>；从已有素材开始时，应上传静态图。</p><h2 id="保存参考照片，在新对话中直接调用"><a href="#保存参考照片，在新对话中直接调用" class="headerlink" title="保存参考照片，在新对话中直接调用"></a>保存参考照片，在新对话中直接调用</h2><p>参考照片可以保存后重复使用。上传照片，请 ChatGPT 将其存为参考，再起一个名称；之后在其他对话中输入 <code>@</code> 加上保存的名称，就能调用该照片。</p><p>例如，把宠物照片命名为 <code>Pepper</code>，后续可输入“为 @Pepper 画一张水彩肖像”。这省去了每次开启新对话都重新上传同一张照片的步骤，适合围绕固定人物或宠物持续创作。</p><p>此前 <a href="/posts/2026/09/chatgpt-images-25-sketch-api/">Images 2.5 的 Sketch 草图与模板功能</a>用于提供构图起点；这次的参考照片复用则把同一份素材带进后续对话。</p><h2 id="普通用户从对话或-Images-入口使用"><a href="#普通用户从对话或-Images-入口使用" class="headerlink" title="普通用户从对话或 Images 入口使用"></a>普通用户从对话或 Images 入口使用</h2><p>用户可以直接在对话中要求生成图片，也可以选择 More → Images。ChatGPT Images 覆盖所有套餐，支持网页、iOS 和 Android；Codex 也能生成和编辑图片。</p><p>需要修改已有图片时，上传图片并说明改动，或打开生成结果后选中局部区域，再输入修改要求。选区不保证精确限定修改范围，保存前仍应检查文字、人物细节和未选中的部分。</p><h2 id="API-增加复杂度控制和-SVG、GIF-输出"><a href="#API-增加复杂度控制和-SVG、GIF-输出" class="headerlink" title="API 增加复杂度控制和 SVG、GIF 输出"></a>API 增加复杂度控制和 SVG、GIF 输出</h2><p>开发者可选用两款模型：</p><table><thead><tr><th>模型 ID</th><th>面向的任务</th></tr></thead><tbody><tr><td><code>gpt-image-2.6-flare</code></td><td>需要快速迭代的图片生成与编辑</td></tr><tr><td><code>gpt-image-2.6-sunburst</code></td><td>细节较多的构图与图片编辑</td></tr></tbody></table><p>两款模型均支持 <code>complexity</code> 参数，取值为 <code>low</code>、<code>medium</code> 或 <code>high</code>，省略时默认为 <code>high</code>。它控制生成前的规划程度；<code>quality</code> 则单独控制画面质量。只改背景或一块招牌时，可以先尝试低复杂度；复杂布局再比较更高档位的结果。</p><p>API 也支持通过独立的透明 PNG 批注层指明修改位置，并提供 SVG 和 GIF 输出。SVG 是由路径、形状等组成的矢量格式，适合需要继续编辑的图标和插画。</p><p>SVG、GIF 都通过图片生成端点输出，图片编辑端点不支持这两种输出格式。接入时需要区分“生成动画”和“编辑图片”这两种请求。</p><h2 id="标准-Token-单价与-2-5-相同"><a href="#标准-Token-单价与-2-5-相同" class="headerlink" title="标准 Token 单价与 2.5 相同"></a>标准 Token 单价与 2.5 相同</h2><p>Flare 和 Sunburst 使用相同的标准 Token 单价，与对应的 2.5 模型一致。Token 是接口用于计算输入、输出用量的单位，不能直接等同于图片张数。</p><table><thead><tr><th>计费项</th><th align="right">两款 2.6 模型的标准价格</th></tr></thead><tbody><tr><td>文本输入</td><td align="right">5 美元／百万 Token</td></tr><tr><td>文本缓存输入</td><td align="right">1.25 美元／百万 Token</td></tr><tr><td>图片输入</td><td align="right">8 美元／百万 Token</td></tr><tr><td>图片缓存输入</td><td align="right">2 美元／百万 Token</td></tr><tr><td>图片输出</td><td align="right">30 美元／百万 Token</td></tr></tbody></table><p>相同单价不保证每张图片成本相同，实际费用取决于用量。SVG 输出还包括生成参考图片和编写矢量内容所用模型的费用；<code>complexity</code> 参数本身没有独立附加费。</p><p>制作表情或角色动作时，可先从 ChatGPT 的单张静态参考图开始；需要把图片生成、批注修改和文件输出接入自己的软件时，再选择 API，并分别核对输出格式和实际用量。</p>]]></content>
    
    
    <summary type="html">OpenAI 发布 ChatGPT Images 2.6，加入 GIF 动图和跨对话复用参考照片。本文介绍生成入口、GIF 编辑限制，以及 Flare、Sunburst 两款 API 模型的复杂度控制、SVG 输出和与 2.5 相同的标准 Token 单价。</summary>


    <category term="多模态" scheme="https://51allai.com/categories/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    
    
    <category term="product-update" scheme="https://51allai.com/tags/product-update/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="chatgpt" scheme="https://51allai.com/tags/chatgpt/"/>
    
    <category term="image-generation" scheme="https://51allai.com/tags/image-generation/"/>
    
  </entry>
  
  <entry>
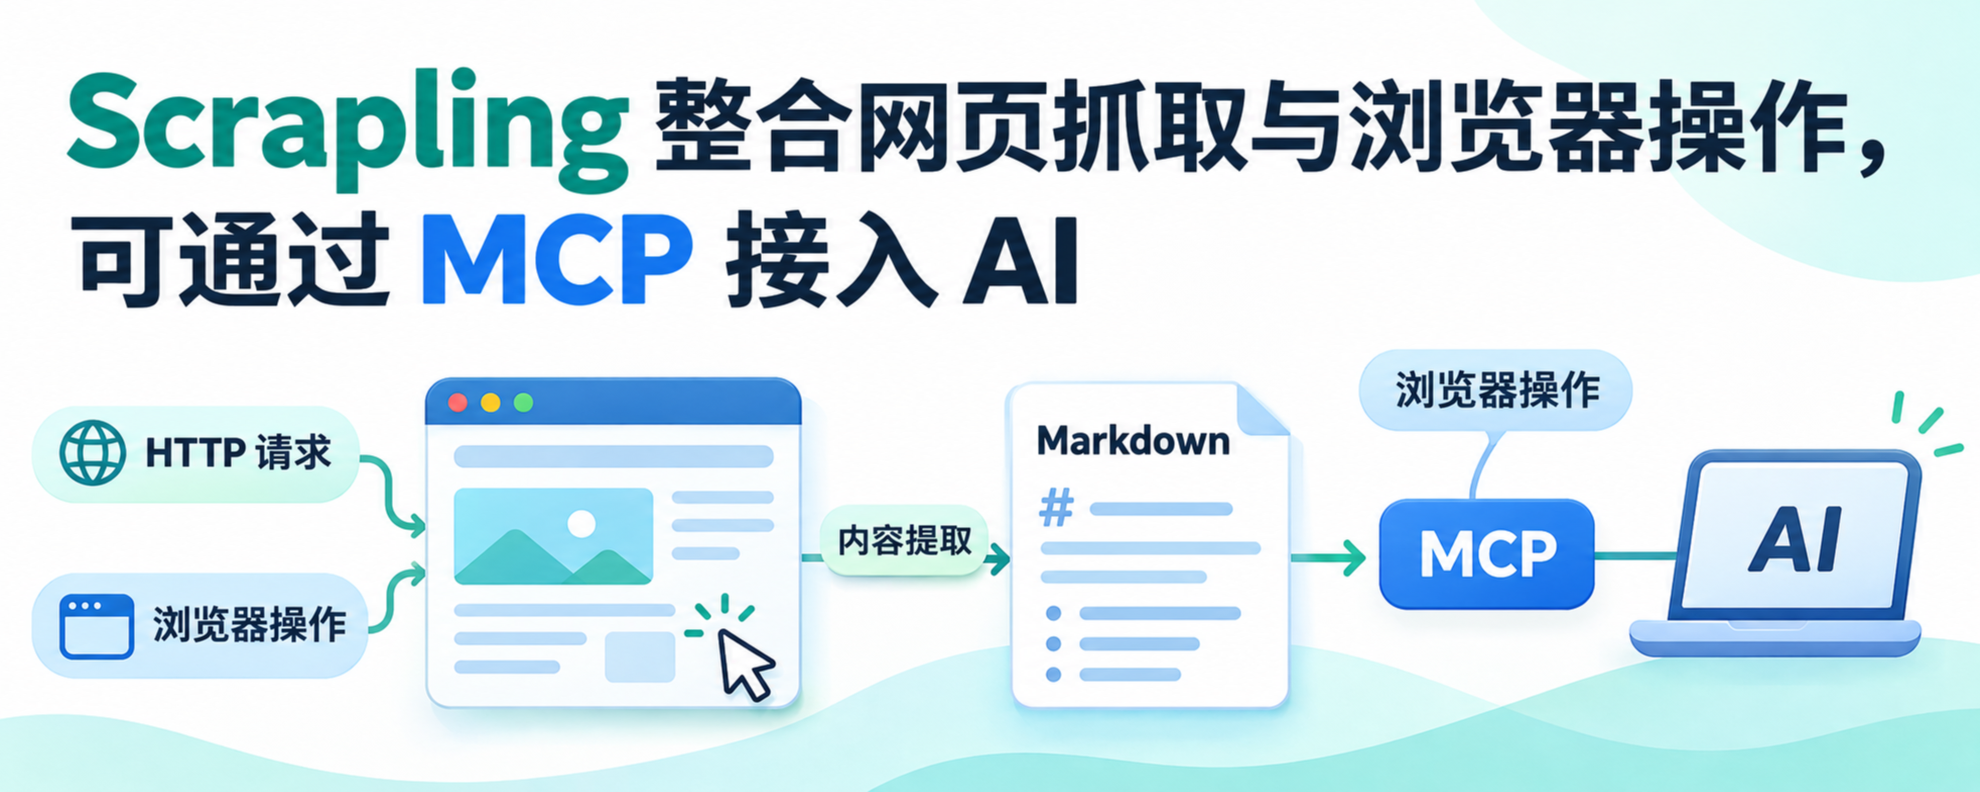
    <title>Scrapling 整合网页抓取与浏览器操作，可通过 MCP 接入 AI</title>
    <link href="https://51allai.com/posts/2026/11/scrapling-web-scraping-mcp/"/>
    <id>https://51allai.com/posts/2026/11/scrapling-web-scraping-mcp/</id>
    <published>2026-11-03T10:54:18.000Z</published>
    <updated>2026-11-03T10:54:18.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>Scrapling 是开源 Python 网页抓取框架，可从网页提取指定字段、导出 Markdown，也能通过 MCP 让 AI 调用浏览器操作、截图和页面读取工具。它要求 Python 3.10 及以上，抓取与 AI 接入需安装相应依赖；适合自建资料采集脚本或为智能体补充网页访问能力。<br><img src="https://images.51allai.com/blog/scrapling-web-scraping-mcp-cover_20261103_190544.png" alt="Scrapling 网页抓取、Markdown 提取与 MCP 浏览器操作流程示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从一个网页到批量采集，用同一套工具处理"><a href="#从一个网页到批量采集，用同一套工具处理" class="headerlink" title="从一个网页到批量采集，用同一套工具处理"></a>从一个网页到批量采集，用同一套工具处理</h2><p><a href="https://github.com/D4Vinci/Scrapling">Scrapling</a> 把网页请求、内容解析、浏览器操作和爬虫调度放在一个 Python 项目中。开发者可以写脚本提取网页字段，也可以在终端里直接把一个链接保存为文本。</p><p>页面类型决定使用方式：</p><table><thead><tr><th>要处理的任务</th><th>对应功能</th><th>可以得到什么</th></tr></thead><tbody><tr><td>正文已经包含在网页响应中</td><td><code>Fetcher</code> 发起 HTTP 请求</td><td>页面内容及选定字段</td></tr><tr><td>内容需要 JavaScript 加载</td><td><code>StealthyFetcher</code> 启动浏览器</td><td>渲染后的页面内容</td></tr><tr><td>需要处理一批页面</td><td>Spider 爬虫框架</td><td>可导出的 JSON、CSV 等数据</td></tr><tr><td>希望 AI 继续点击、填写和读取页面</td><td>MCP 服务</td><td>可反复调用的浏览器工具</td></tr></tbody></table><p>HTTP 请求是程序直接向网站获取内容；浏览器抓取还会运行页面脚本，适合打开后才加载数据的网页。批量任务可以设置并发、域名访问间隔和重试，并复用会话，保留多次请求之间的 Cookie 等状态。</p><p>已有<a href="/posts/2026/10/deepseek-api-search-fetch/">按次调用的网页搜索与抓取 API</a>适合直接接入托管服务。Scrapling 则由使用者部署和运行，适合需要自己控制提取规则、浏览器步骤和输出文件的工作流。</p><h2 id="安装额外依赖后，一条命令导出-Markdown"><a href="#安装额外依赖后，一条命令导出-Markdown" class="headerlink" title="安装额外依赖后，一条命令导出 Markdown"></a>安装额外依赖后，一条命令导出 Markdown</h2><p>Scrapling 要求 <strong>Python 3.10 或以上版本</strong>。基础安装 <code>pip install scrapling</code> 只包含页面解析器。需要命令行提取功能时，可以在虚拟环境中安装带 <code>shell</code> 依赖的版本：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">python3 -m venv .venv</span><br><span class="line"><span class="built_in">source</span> .venv/bin/activate</span><br><span class="line">python -m pip install <span class="string">&quot;scrapling[shell]&quot;</span></span><br><span class="line">scrapling extract get <span class="string">&quot;https://example.com&quot;</span> page.md --ai-targeted</span><br></pre></td></tr></table></figure><p>上面的环境激活命令适用于 macOS、Linux 的常见 shell。输出文件使用 <code>.md</code> 后缀，就会将 HTML 转为 Markdown；Markdown 用标题、列表等文本标记保留文档结构，便于继续交给 AI 阅读。改用 <code>.html</code> 或 <code>.txt</code>，可以分别保存 HTML 或纯文本。</p><p><code>--ai-targeted</code> 会限定在页面 body 内容中提取，并清理脚本、样式及部分隐藏内容。需要只取某个正文区域时，还可以加入 <code>--css-selector &quot;article&quot;</code>。CSS 选择器是一种按页面标签和属性定位内容的规则，实际规则需要匹配目标网页。</p><p>仅使用 HTTP 请求无需安装浏览器。需要运行页面脚本时，再执行 <code>scrapling install</code> 下载浏览器及相关依赖，并使用 <code>scrapling extract fetch</code> 等浏览器抓取入口。</p><h2 id="通过-MCP，AI-可以继续操作同一个页面"><a href="#通过-MCP，AI-可以继续操作同一个页面" class="headerlink" title="通过 MCP，AI 可以继续操作同一个页面"></a>通过 MCP，AI 可以继续操作同一个页面</h2><p>MCP 是让 AI 应用连接外部工具的协议。安装 <code>scrapling[ai]</code> 并完成浏览器依赖安装后，可以把 <code>scrapling-mcp</code> 可执行文件配置到支持 MCP 的客户端，例如 Claude Desktop 或 Cursor。</p><p>连接后，AI 可以发起单次网页请求，也可以打开持续使用的浏览器会话，在同一页面上填写表单、点击、滚动、等待内容出现，再读取结果或截图。页面内容可按 HTML、Markdown 或文本返回，也可以先按选择器缩小提取范围。</p><p>v0.5 还提供已记录网络请求的读取，以及登录状态的保存和恢复。网络记录可用于检查网页背后返回的文本接口数据；登录状态文件保存 Cookie、本地存储和 IndexedDB 等浏览器数据，不包含已打开标签页和浏览器设置。</p><p>网页提取完成后，资料才进入 AI 可处理的范围。总结、对比和回答问题仍由连接的模型或后续程序完成。用来构建知识库时，也需要继续完成文本切分、检索存储等步骤。</p><h2 id="自适应匹配依靠已保存的元素特征"><a href="#自适应匹配依靠已保存的元素特征" class="headerlink" title="自适应匹配依靠已保存的元素特征"></a>自适应匹配依靠已保存的元素特征</h2><p>网站改版可能改变标签层级或属性，让原来的提取规则失效。Scrapling 的自适应解析允许先保存目标元素的特征，之后按文本、属性、父级结构等信息计算相似度，尝试重新定位。</p><p>这一步使用相似度算法，无需调用大模型。它需要先保存有效样本；同一次选择结果中，默认只保存首个元素的特征。用于商品列表、文章列表等重复内容时，需要检查匹配结果是否仍指向预期字段。</p><p>批量爬取还支持用 <code>crawldir</code> 保存待处理请求与已见 URL，在停止后继续任务。已提取的数据需要另外导出，不能把恢复爬取等同于已经保存全部结果。</p><h2 id="适合自建采集流程，先检查输出再接入-AI"><a href="#适合自建采集流程，先检查输出再接入-AI" class="headerlink" title="适合自建采集流程，先检查输出再接入 AI"></a>适合自建采集流程，先检查输出再接入 AI</h2><p>Scrapling 采用 BSD-3-Clause 开源许可证。网页转 Markdown 和规则提取本身无需调用大模型；运行机器、存储、可选代理和后续 AI 服务的成本由使用者承担。</p><p>需要定期收集公开资料、把网页字段写入数据文件，或让 AI 在页面中完成连续操作的开发者，可以从单页提取开始。输出文件生成后，先核对正文、字段和链接，确认没有把登录页、错误页或导航内容当成目标资料，再扩大到批量任务。</p><p>已有旧版 Scrapling 脚本的用户，升级 v0.5 前应先检查<a href="https://scrapling.readthedocs.io/en/latest/migrating-to-v0.5.html">迁移指南</a>，该版本包含不兼容改动。</p>]]></content>
    
    
    <summary type="html">Scrapling 是开源 Python 网页抓取框架，整合静态请求、动态网页渲染、内容提取和批量爬取，也能通过 MCP 为 AI 提供浏览器操作工具。本文梳理安装依赖、Markdown 导出、自适应匹配与适用场景，说明抓取结果进入 AI 工作流前需要检查什么。</summary>


    <category term="智能体" scheme="https://51allai.com/categories/%E6%99%BA%E8%83%BD%E4%BD%93/"/>
    
    
    <category term="workflow-automation" scheme="https://51allai.com/tags/workflow-automation/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="open-source" scheme="https://51allai.com/tags/open-source/"/>
    
    <category term="scrapling" scheme="https://51allai.com/tags/scrapling/"/>
    
  </entry>
  
  <entry>
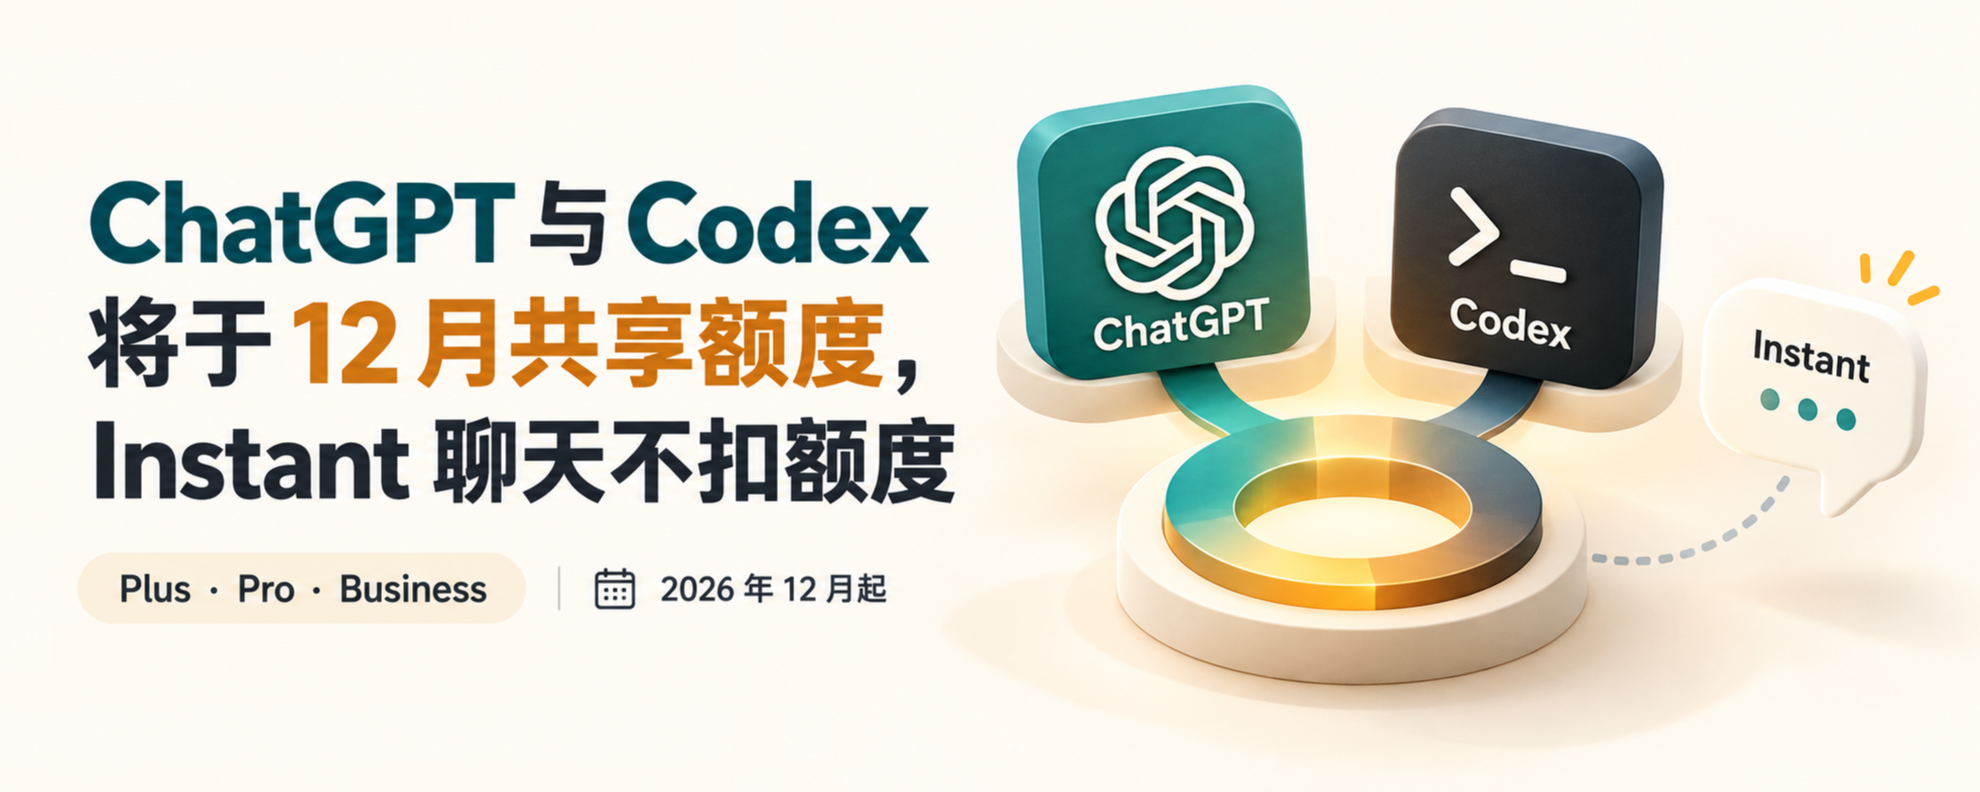
    <title>ChatGPT 与 Codex 将于 12 月共享额度，Instant 聊天不扣额度</title>
    <link href="https://51allai.com/posts/2026/11/chatgpt-codex-shared-usage/"/>
    <id>https://51allai.com/posts/2026/11/chatgpt-codex-shared-usage/</id>
    <published>2026-11-02T05:28:59.000Z</published>
    <updated>2026-11-02T05:28:59.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>ChatGPT 与 Codex 将从 2026 年 12 月起共享 Plus、Pro、Business 套餐的用量额度，配合 Work 的智能体能力并入 ChatGPT 主体验。用量按 Token 计量，Instant 聊天不消耗这份额度；用户将能在“设置 → 用量”查看合并后的余量与重置时间。<br><img src="https://images.51allai.com/blog/chatgpt-codex-shared-usage-cover_20261102_133443.png" alt="ChatGPT 与 Codex 12 月共享额度及 Instant 聊天豁免示意" fetchpriority="high" decoding="async"></p></blockquote><h2 id="12-月起，ChatGPT-与-Codex-共用套餐额度"><a href="#12-月起，ChatGPT-与-Codex-共用套餐额度" class="headerlink" title="12 月起，ChatGPT 与 Codex 共用套餐额度"></a>12 月起，ChatGPT 与 Codex 共用套餐额度</h2><p>这次调整适用于 ChatGPT Plus、Pro 和 Business 用户。ChatGPT 是日常对话与处理任务的入口，Codex 主要用于编写、修改和检查代码。12 月起，两者纳入同一套套餐用量管理；Instant 聊天保留豁免，不扣除这份共享额度。</p><p>此前，<a href="/posts/2026/08/openai-plus-codex-five-hour-limit/">ChatGPT Work 与 Codex 已经共享用量</a>。Work 是用于多步骤任务、调用工具完成工作的模式。随着这些智能体能力并入 ChatGPT 主体验，共享规则也将覆盖新的 ChatGPT 使用流程。</p><p>对同时用 ChatGPT 处理工作、用 Codex 开发软件的人来说，需要一起查看两边的消耗，安排剩余用量。<a href="https://help.openai.com/en/articles/20001625-understanding-chatgpt-and-codex-usage-limits">ChatGPT 与 Codex 用量规则</a>可用于核对适用范围。</p><h2 id="按-Token-计量，一条消息的消耗取决于任务"><a href="#按-Token-计量，一条消息的消耗取决于任务" class="headerlink" title="按 Token 计量，一条消息的消耗取决于任务"></a>按 Token 计量，一条消息的消耗取决于任务</h2><p>Token 是模型读取和生成信息时使用的计量单位。提示词、文件、聊天历史、工具返回的结果和模型回复都会产生 Token。相同条数的消息，实际消耗可能不同。</p><p>模型选择和任务复杂程度会影响额度使用。更高级的模型、需要处理大量上下文或连续调用工具的任务，通常消耗更多；不能只凭输入了多少字来估算剩余可用次数。</p><p>套餐内用量与额外购买的积分需要分开理解：前者是订阅包含的使用额度，后者用于继续使用符合条件的功能。按 Token 衡量任务消耗，并不等于每发一条消息就产生一笔额外付款。</p><h2 id="在“设置-→-用量”查看统一余量"><a href="#在“设置-→-用量”查看统一余量" class="headerlink" title="在“设置 → 用量”查看统一余量"></a>在“设置 → 用量”查看统一余量</h2><p>新规则生效后，用户将能在 ChatGPT 的 <strong>设置 → 用量（Settings → Usage）</strong> 中查看合并后的剩余用量和重置时间。使用 Codex 命令行时，也可以通过 <code>/status</code> 查看当前会话对应的用量状态。</p><p>达到上限后，可以等待额度重置、升级套餐，或购买积分继续使用符合条件的功能。安排长任务前先查看余量，比单纯统计当天发出了多少条消息更有帮助。</p><h2 id="API-密钥使用量仍单独计费"><a href="#API-密钥使用量仍单独计费" class="headerlink" title="API 密钥使用量仍单独计费"></a>API 密钥使用量仍单独计费</h2><p>通过 ChatGPT 账号使用套餐，与通过 API 密钥运行 Codex，是两种计费路径。API 是供程序调用模型的接口；使用 API 密钥时，Codex 按 API 价格计费，费用与 ChatGPT 订阅用量分开。</p><p>日常使用中，可以缩小一次任务的范围，只提供相关文件和必要上下文，并让输出长度匹配实际用途。需要反复处理大型文件或代码库时，先检查模型选择与任务范围，再决定继续使用套餐额度还是另行支付 API 费用。</p>]]></content>
    
    
    <summary type="html">ChatGPT 与 Codex 将于 12 月起在 Plus、Pro、Business 套餐中共享用量额度，Instant 聊天不扣这份额度。本文说明 Token 如何计量、统一余量的查看入口、达到上限后的选择，以及套餐用量与 API 计费的区别。</summary>


    <category term="行业观察" scheme="https://51allai.com/categories/%E8%A1%8C%E4%B8%9A%E8%A7%82%E5%AF%9F/"/>
    
    
    <category term="product-update" scheme="https://51allai.com/tags/product-update/"/>
    
    <category term="pricing" scheme="https://51allai.com/tags/pricing/"/>
    
    <category term="openai" scheme="https://51allai.com/tags/openai/"/>
    
    <category term="chatgpt" scheme="https://51allai.com/tags/chatgpt/"/>
    
    <category term="codex" scheme="https://51allai.com/tags/codex/"/>
    
  </entry>
  
  <entry>
    <title>DeepSeek 开源 Super-agent 原型，支持 GitHub 与飞书协作</title>
    <link href="https://51allai.com/posts/2026/11/deepseek-superagent-prototype/"/>
    <id>https://51allai.com/posts/2026/11/deepseek-superagent-prototype/</id>
    <published>2026-11-01T01:57:27.000Z</published>
    <updated>2026-11-01T01:57:27.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>DeepSeek 开源 Super-agent 研究原型 dsh-superagent-prototype，基于 Harness 连接 GitHub 和可选的飞书消息，将获准的工作交给独立会话执行，再回到原讨论交付结果。代码采用 MIT 许可证，面向单个仓库；主动接单默认只记录判断，适合开发者研究团队协作式 Agent 的运行机制。<br><img src="https://images.51allai.com/blog/deepseek-superagent-prototype-cover_20261101_100921.png" alt="DeepSeek Super-agent 原型的任务分派与 GitHub 飞书协作流程" fetchpriority="high" decoding="async"></p></blockquote><h2 id="从讨论接收任务，再回到原处交付"><a href="#从讨论接收任务，再回到原处交付" class="headerlink" title="从讨论接收任务，再回到原处交付"></a>从讨论接收任务，再回到原处交付</h2><p><a href="https://github.com/deepseek-ai/dsh-superagent-prototype">dsh-superagent-prototype</a> 是 DeepSeek Harness 团队开源的编程智能体研究原型。Agent，也就是智能体，在这里指能围绕目标调用工具、修改代码并跟进结果的 AI。项目以 Harness 插件组合包运行，服务于一个 GitHub 仓库，也可以接入飞书。</p><p>一个典型流程是：获准的团队成员在 GitHub 讨论中向智能体提出请求，系统建立任务，在独立会话和目录中处理代码，随后把结果发回原讨论。交付物可以是一份 Pull Request（PR，即请求团队审查并合并代码的变更）。接入飞书后，团队也能从聊天中发起工作。</p><p>这套机制适合围绕同一代码仓库协作的团队，以及想研究任务调度、授权和消息衔接的开发者。它定位为研究代码，使用前需要审查并适配自己的环境。</p><h2 id="主会话分派工作，执行器处理代码"><a href="#主会话分派工作，执行器处理代码" class="headerlink" title="主会话分派工作，执行器处理代码"></a>主会话分派工作，执行器处理代码</h2><p>Super-agent 把任务协调和具体执行分开。主会话使用 Router 角色，负责判断消息该建立新任务、补充已有任务，还是忽略；Worker 则是执行器，负责推进一项已接受的工作。</p><table><thead><tr><th>环节</th><th>具体处理方式</th></tr></thead><tbody><tr><td>消息接入</td><td>GitHub 和飞书消息进入系统，按发送者、会话范围和策略判断能否发起工作</td></tr><tr><td>任务分派</td><td>主会话接受任务或把后续消息交给已有任务，并保留授权范围</td></tr><tr><td>代码执行</td><td>每个任务有自己的执行会话和目录，可用 Git worktree 准备同一仓库的独立检出目录</td></tr><tr><td>人工处理</td><td>Web 面板集中展示等待回答、等待审查、受阻或失败的任务</td></tr></tbody></table><p>执行器的并发数量可以配置，默认是 3 个。任务排队、执行与等待人工处理有不同状态，用户可以在面板查看某项工作停在哪里。</p><p>任务与原讨论的关联也会保留。审查意见或后续消息可以送回对应执行器，让它继续处理；超出原任务范围的请求则交回主会话重新分派。系统还保存任务、订阅和待处理消息，重启后可据此恢复工作。</p><p>对已有 <a href="/posts/2026/08/deepseek-harness-developer-preview/">DeepSeek Harness 开发者预览版</a>使用经验的读者，这次原型增加的是围绕团队消息建立、分派和持续跟进任务的一套流程。</p><h2 id="主动接单默认先观察"><a href="#主动接单默认先观察" class="headerlink" title="主动接单默认先观察"></a>主动接单默认先观察</h2><p>“主动”由授权策略和规则控制。名单内成员直接向智能体提出的请求，可以按明确请求处理；系统从其他消息中推断出的潜在工作，需要经过规则评估。</p><p>主动接单有三种模式：</p><table><thead><tr><th>模式</th><th>对推断出的工作的处理</th></tr></thead><tbody><tr><td><code>off</code></td><td>不接收这类候选工作</td></tr><tr><td><code>observe</code></td><td>评估并记录“本来会接受”的任务，不启动执行</td></tr><tr><td><code>auto</code></td><td>评估通过且至少命中一条已启用规则时，接受任务</td></tr></tbody></table><p>默认值是 <code>observe</code>。团队可以先检查判断记录，确认规则和接收范围，再决定是否改为 <code>auto</code>。获准用户的明确请求在这三种模式下都能处理，观察模式只限制推断出的主动工作。</p><p>每项任务会记录接受时的策略版本和授权范围。讨论消息、评论和引用文档用于理解任务，本身不能改写这些权限。用户也可以在面板直接停止某项任务。</p><h2 id="如何开始试用"><a href="#如何开始试用" class="headerlink" title="如何开始试用"></a>如何开始试用</h2><p>安装需要 Node.js 22.19 及以上的 22.x 版本或 24 及以上版本，以及 pnpm、Git 2.32+、Python 3.8+、tmux、GitHub CLI 2.48+。Harness 还需配置可用的模型服务；部署示例固定使用 <code>@deepseek-ai/dsh@0.2.1-rc.3</code>。</p><p>先获取代码：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">git <span class="built_in">clone</span> https://github.com/deepseek-ai/dsh-superagent-prototype.git</span><br><span class="line"><span class="built_in">cd</span> dsh-superagent-prototype</span><br></pre></td></tr></table></figure><p>然后让编程助手读取仓库中的 <a href="https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md"><code>SETUP.md</code></a>，协助完成安装。可以直接输入：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Read SETUP.md in this repository and set up dsh-superagent with me.</span><br></pre></td></tr></table></figure><p>引导流程会收集目标仓库、智能体账号、允许发起任务的成员、代码检出位置和合并方式，汇总计划后等待用户确认，再安装和配置。账号登录与密钥输入在用户自己的终端完成。</p><p>手动安装则从<a href="https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md">部署文档</a>进入：构建插件、创建独立的 <code>superagent</code> Harness 配置、链接插件，再设置仓库和执行目录。服务启动后，在 Harness Web 侧栏打开 Superagent 面板。面板优先显示需要人处理的工作，也能查看系统健康和单项任务的历史。</p><h2 id="试用前要确认的运行边界"><a href="#试用前要确认的运行边界" class="headerlink" title="试用前要确认的运行边界"></a>试用前要确认的运行边界</h2><p>当前原型服务于 <code>github.com</code> 上的单个仓库，不支持 GitHub Enterprise Server。智能体需要专用 GitHub 用户账号及仓库写权限；由于依赖账号通知，GitHub App 不能替代这个账号。飞书接入还需额外配置机器人和 <code>lark-cli</code>。</p><p><strong>独立任务目录不等于操作系统隔离。</strong> 执行器以运行服务的系统用户身份执行命令，无需逐条审批，并可读取该用户的主目录。若要隔离个人文件和凭据，应使用只保存智能体所需凭据的专用系统账号。</p><p>代码采用 MIT 许可证，可以按许可要求使用和修改。公开版本是经过整理的研究原型，与内部实现及完整设计文章有区别。试用时应以仓库中的功能和部署流程为准，先选择一个范围清楚的仓库任务，通过观察记录和 PR 审查确认它的行为。</p>]]></content>
    
    
    <summary type="html">DeepSeek 开源 dsh-superagent-prototype，以 Harness 插件组合包连接 GitHub 和飞书，将任务分派与代码执行分开。本文介绍研究原型的工作流程、默认观察模式、安装入口及账号权限边界，帮助开发者判断是否适合试用。</summary>


    <category term="智能体" scheme="https://51allai.com/categories/%E6%99%BA%E8%83%BD%E4%BD%93/"/>
    
    
    <category term="coding-agent" scheme="https://51allai.com/tags/coding-agent/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="agent-framework" scheme="https://51allai.com/tags/agent-framework/"/>
    
    <category term="open-source" scheme="https://51allai.com/tags/open-source/"/>
    
    <category term="deepseek" scheme="https://51allai.com/tags/deepseek/"/>
    
  </entry>
  
  <entry>
    <title>灵光 App 发布 2.0，支持持续跟进任务与主动提醒</title>
    <link href="https://51allai.com/posts/2026/10/lingguang-2-personal-ai-assistant/"/>
    <id>https://51allai.com/posts/2026/10/lingguang-2-personal-ai-assistant/</id>
    <published>2026-10-27T12:28:57.000Z</published>
    <updated>2026-10-27T12:28:57.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>10 月 27 日，蚂蚁集团发布灵光 App 2.0，加入“帮我管”事务管理入口。用户可以把需要持续关注的事情交给 AI，离开对话后继续跟进，并在有变化时收到提醒。新版支持授权连接支付宝等服务，核对续费记录、查看任务进度，授权可随时调整或撤销。<br><img src="https://images.51allai.com/blog/lingguang-2-personal-ai-assistant-cover_20261027_203751.png" alt="灵光 App 2.0 帮我管与持续任务提醒主题封面" fetchpriority="high" decoding="async"></p></blockquote><h2 id="“帮我管”把一次对话延伸为持续任务"><a href="#“帮我管”把一次对话延伸为持续任务" class="headerlink" title="“帮我管”把一次对话延伸为持续任务"></a>“帮我管”把一次对话延伸为持续任务</h2><p><a href="https://www.lingguang.com/chat">灵光</a>是蚂蚁集团推出的 AI 助手，原有功能包括搜索问答、拍照识图、图片与视频创作，以及用一句话生成可以交互和编辑的“闪应用”。这次 2.0 更新增加了围绕同一件事持续安排、跟进和提醒的功能。</p><p>新的入口叫“帮我管”。用户交代目标后，灵光可以围绕这件事组织步骤、记住偏好，随进展更新计划、清单和记录。打开这一入口，可以查看已经完成的内容和接下来要做的事。</p><p>例如，准备在电商大促期间买手机，可以把挑选机型、多平台优惠比价和降价提醒放在同一项事务中。任务需要持续关注时，离开对话后，灵光仍会按约定跟进；出现需要留意的变化，再提醒用户并给出下一步建议。</p><h2 id="能持续关注哪些事情"><a href="#能持续关注哪些事情" class="headerlink" title="能持续关注哪些事情"></a>能持续关注哪些事情</h2><p>2.0 的功能覆盖购物、出行和日常信息管理。不同任务需要的资料和服务连接也不同。</p><table><thead><tr><th>事务</th><th>灵光可以处理的内容</th></tr></thead><tbody><tr><td>会员续费核对</td><td>授权连接支付宝后，核对续费服务、梳理扣款记录并计算累计支出</td></tr><tr><td>购物比价</td><td>围绕购买目标挑选机型、比较多平台优惠，并持续关注降价</td></tr><tr><td>出行变化</td><td>按约定关注机票价格、出行天气和路况变化，在需要留意时提醒</td></tr><tr><td>演出信息</td><td>持续关注演唱会开票、加场信息，提醒用户采取下一步行动</td></tr><tr><td>长期计划</td><td>在“帮我管”中查看房源筛选、训练或购物等事务的计划、清单与进度</td></tr></tbody></table><p>这类功能适合有明确目标、又需要反复查询信息的人。交代需求时，可以把关注对象和提醒条件一起说明，例如具体要买哪款手机、准备何时出行，让持续跟进围绕实际目标展开。</p><h2 id="连接服务前授权，后续可以撤销"><a href="#连接服务前授权，后续可以撤销" class="headerlink" title="连接服务前授权，后续可以撤销"></a>连接服务前授权，后续可以撤销</h2><p>支付宝连接用于核对续费服务和扣款记录。灵光还支持连接钉钉、飞书、滴滴出行及智能硬件，把不同服务的信息与操作接入任务。</p><p>服务连接以用户授权为前提。灵光将蚂蚁 APASS 纳入任务执行流程；它负责账号与授权凭证的独立加密保护，使智能体执行任务时无需直接接触授权密钥。这里的“智能体”，就是能够根据目标组织步骤、调用工具完成任务的 AI 助手。</p><p>用户可以随时查看、调整或撤销授权，控制灵光处理事务的范围。开始使用时，可以先选择一件具体的事，再为它连接所需服务。</p><h2 id="如何下载与辨认新版"><a href="#如何下载与辨认新版" class="headerlink" title="如何下载与辨认新版"></a>如何下载与辨认新版</h2><p>手机用户可从灵光官网的“下载灵光手机应用”入口获取 App。iPhone 用户也可以在 App Store 搜索“灵光-能管事的个人助理”，核对开发者为 Alipay (Hangzhou) Technology Co., Ltd. 后下载或更新。</p><p>需要留意两个版本名称：<strong>这次产品升级称为灵光 2.0，对应的 iOS 安装包版本号是 1.3.80</strong>，更新说明为“灵光2.0全新升级！”。查找更新时，可以用这条说明辨认。</p><p>iOS 应用可免费下载，要求 iOS 15.0 或更高版本。更新后进入“帮我管”，先交代需要持续跟进的目标，再按任务需要完成服务授权，就可以查看相关计划、清单和后续进度。</p>]]></content>
    
    
    <summary type="html">灵光 App 发布 2.0，新增“帮我管”事务管理入口，可在授权后核对支付宝续费记录、持续关注价格与出行变化，并查看任务进度。本文梳理功能范围、授权控制及下载方式，说明产品 2.0 与 iOS 1.3.80 版本号的区别。</summary>


    <category term="智能体" scheme="https://51allai.com/categories/%E6%99%BA%E8%83%BD%E4%BD%93/"/>
    
    
    <category term="product-update" scheme="https://51allai.com/tags/product-update/"/>
    
    <category term="ai-agents" scheme="https://51allai.com/tags/ai-agents/"/>
    
    <category term="lingguang" scheme="https://51allai.com/tags/lingguang/"/>
    
  </entry>
  
</feed>