


Scrapling 是开源 Python 网页抓取框架,可从网页提取指定字段、导出 Markdown,也能通过 MCP 让 AI 调用浏览器操作、截图和页面读取工具。它要求 Python 3.10 及以上,抓取与 AI 接入需安装相应依赖;适合自建资料采集脚本或为智能体补充网页访问能力。
从一个网页到批量采集,用同一套工具处理
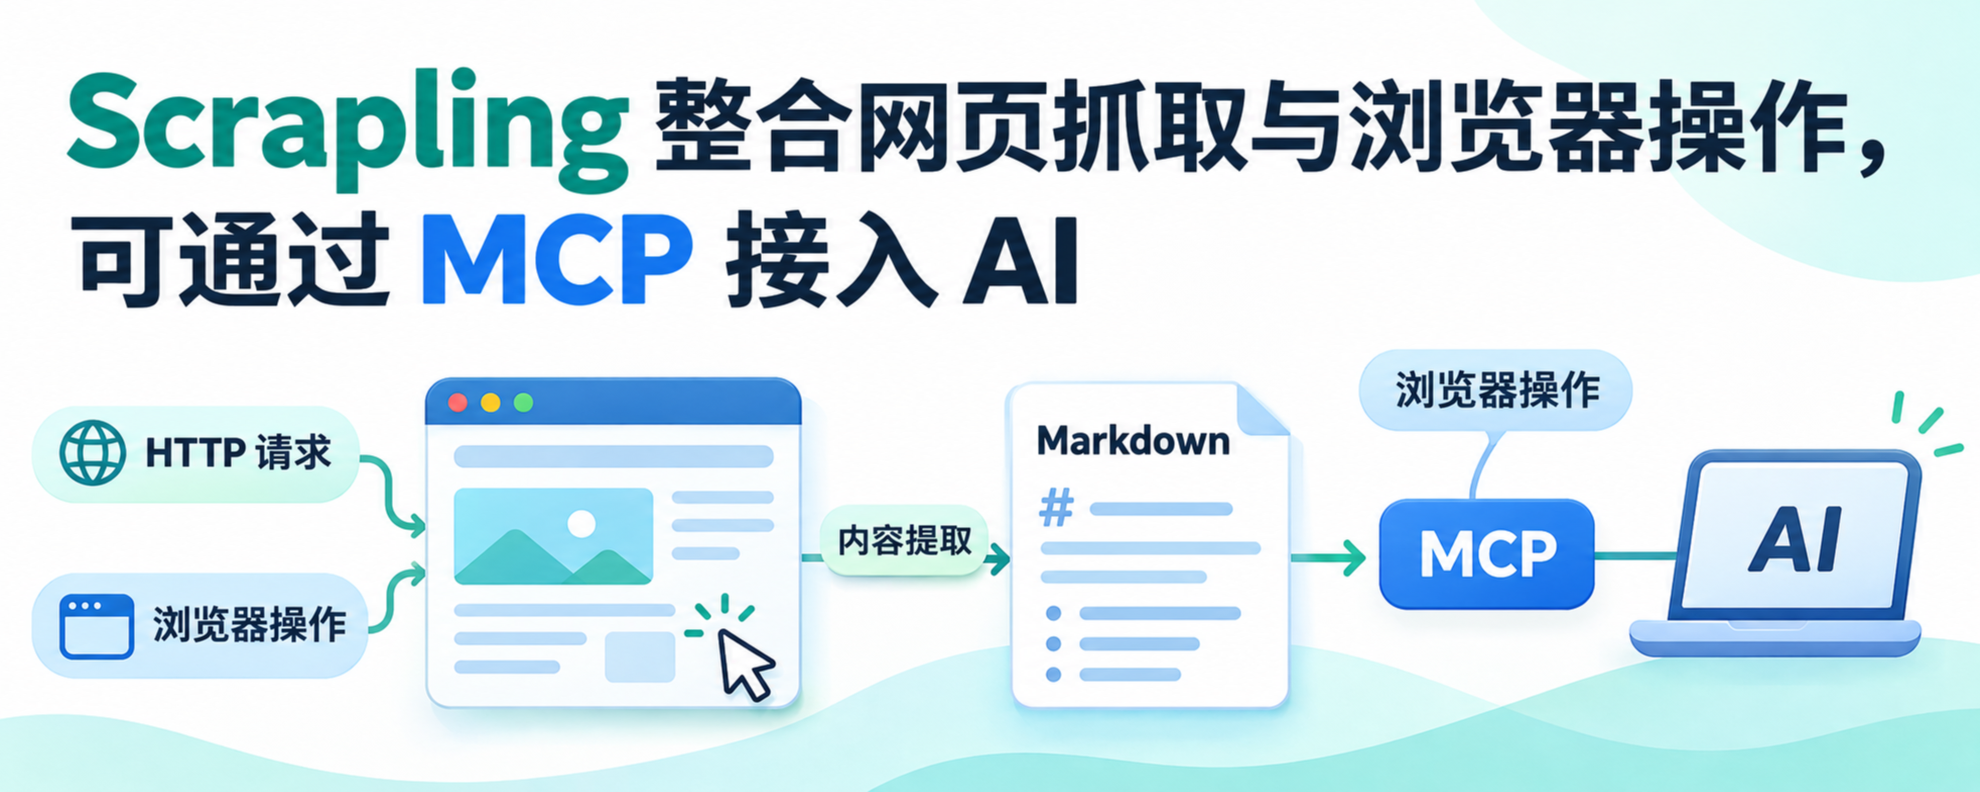
Scrapling 把网页请求、内容解析、浏览器操作和爬虫调度放在一个 Python 项目中。开发者可以写脚本提取网页字段,也可以在终端里直接把一个链接保存为文本。
页面类型决定使用方式:
| 要处理的任务 | 对应功能 | 可以得到什么 |
|---|---|---|
| 正文已经包含在网页响应中 | Fetcher 发起 HTTP 请求 |
页面内容及选定字段 |
| 内容需要 JavaScript 加载 | StealthyFetcher 启动浏览器 |
渲染后的页面内容 |
| 需要处理一批页面 | Spider 爬虫框架 | 可导出的 JSON、CSV 等数据 |
| 希望 AI 继续点击、填写和读取页面 | MCP 服务 | 可反复调用的浏览器工具 |
HTTP 请求是程序直接向网站获取内容;浏览器抓取还会运行页面脚本,适合打开后才加载数据的网页。批量任务可以设置并发、域名访问间隔和重试,并复用会话,保留多次请求之间的 Cookie 等状态。
已有按次调用的网页搜索与抓取 API适合直接接入托管服务。Scrapling 则由使用者部署和运行,适合需要自己控制提取规则、浏览器步骤和输出文件的工作流。
安装额外依赖后,一条命令导出 Markdown
Scrapling 要求 Python 3.10 或以上版本。基础安装 pip install scrapling 只包含页面解析器。需要命令行提取功能时,可以在虚拟环境中安装带 shell 依赖的版本:
1 | python3 -m venv .venv |
上面的环境激活命令适用于 macOS、Linux 的常见 shell。输出文件使用 .md 后缀,就会将 HTML 转为 Markdown;Markdown 用标题、列表等文本标记保留文档结构,便于继续交给 AI 阅读。改用 .html 或 .txt,可以分别保存 HTML 或纯文本。
--ai-targeted 会限定在页面 body 内容中提取,并清理脚本、样式及部分隐藏内容。需要只取某个正文区域时,还可以加入 --css-selector "article"。CSS 选择器是一种按页面标签和属性定位内容的规则,实际规则需要匹配目标网页。
仅使用 HTTP 请求无需安装浏览器。需要运行页面脚本时,再执行 scrapling install 下载浏览器及相关依赖,并使用 scrapling extract fetch 等浏览器抓取入口。
通过 MCP,AI 可以继续操作同一个页面
MCP 是让 AI 应用连接外部工具的协议。安装 scrapling[ai] 并完成浏览器依赖安装后,可以把 scrapling-mcp 可执行文件配置到支持 MCP 的客户端,例如 Claude Desktop 或 Cursor。
连接后,AI 可以发起单次网页请求,也可以打开持续使用的浏览器会话,在同一页面上填写表单、点击、滚动、等待内容出现,再读取结果或截图。页面内容可按 HTML、Markdown 或文本返回,也可以先按选择器缩小提取范围。
v0.5 还提供已记录网络请求的读取,以及登录状态的保存和恢复。网络记录可用于检查网页背后返回的文本接口数据;登录状态文件保存 Cookie、本地存储和 IndexedDB 等浏览器数据,不包含已打开标签页和浏览器设置。
网页提取完成后,资料才进入 AI 可处理的范围。总结、对比和回答问题仍由连接的模型或后续程序完成。用来构建知识库时,也需要继续完成文本切分、检索存储等步骤。
自适应匹配依靠已保存的元素特征
网站改版可能改变标签层级或属性,让原来的提取规则失效。Scrapling 的自适应解析允许先保存目标元素的特征,之后按文本、属性、父级结构等信息计算相似度,尝试重新定位。
这一步使用相似度算法,无需调用大模型。它需要先保存有效样本;同一次选择结果中,默认只保存首个元素的特征。用于商品列表、文章列表等重复内容时,需要检查匹配结果是否仍指向预期字段。
批量爬取还支持用 crawldir 保存待处理请求与已见 URL,在停止后继续任务。已提取的数据需要另外导出,不能把恢复爬取等同于已经保存全部结果。
适合自建采集流程,先检查输出再接入 AI
Scrapling 采用 BSD-3-Clause 开源许可证。网页转 Markdown 和规则提取本身无需调用大模型;运行机器、存储、可选代理和后续 AI 服务的成本由使用者承担。
需要定期收集公开资料、把网页字段写入数据文件,或让 AI 在页面中完成连续操作的开发者,可以从单页提取开始。输出文件生成后,先核对正文、字段和链接,确认没有把登录页、错误页或导航内容当成目标资料,再扩大到批量任务。
已有旧版 Scrapling 脚本的用户,升级 v0.5 前应先检查迁移指南,该版本包含不兼容改动。
原始来源
以下资料用于核对本文信息;价格、开放范围与产品状态请以来源的最新说明为准。
- Scrapling GitHub 项目与安装说明 — Python 环境、可选依赖、抓取与爬虫功能、开源许可
- Scrapling v0.5 发布说明 — 浏览器操作、页面提取、网络记录、登录状态保存与升级兼容性
- Scrapling MCP 接入指南 — AI 工具连接方式、浏览器会话、操作与截图范围
- Scrapling 命令行提取指南 — Markdown 导出、CSS 选择器及 AI 内容清理参数
- Scrapling 自适应解析指南 — 元素特征保存、相似度匹配机制及首个元素限制
- Scrapling 网页转 Markdown 与知识库接入指南 — 内容转换无需调用模型、整站采集及后续知识库处理步骤
- Scrapling v0.5 迁移指南 — 旧版脚本升级时的不兼容改动