


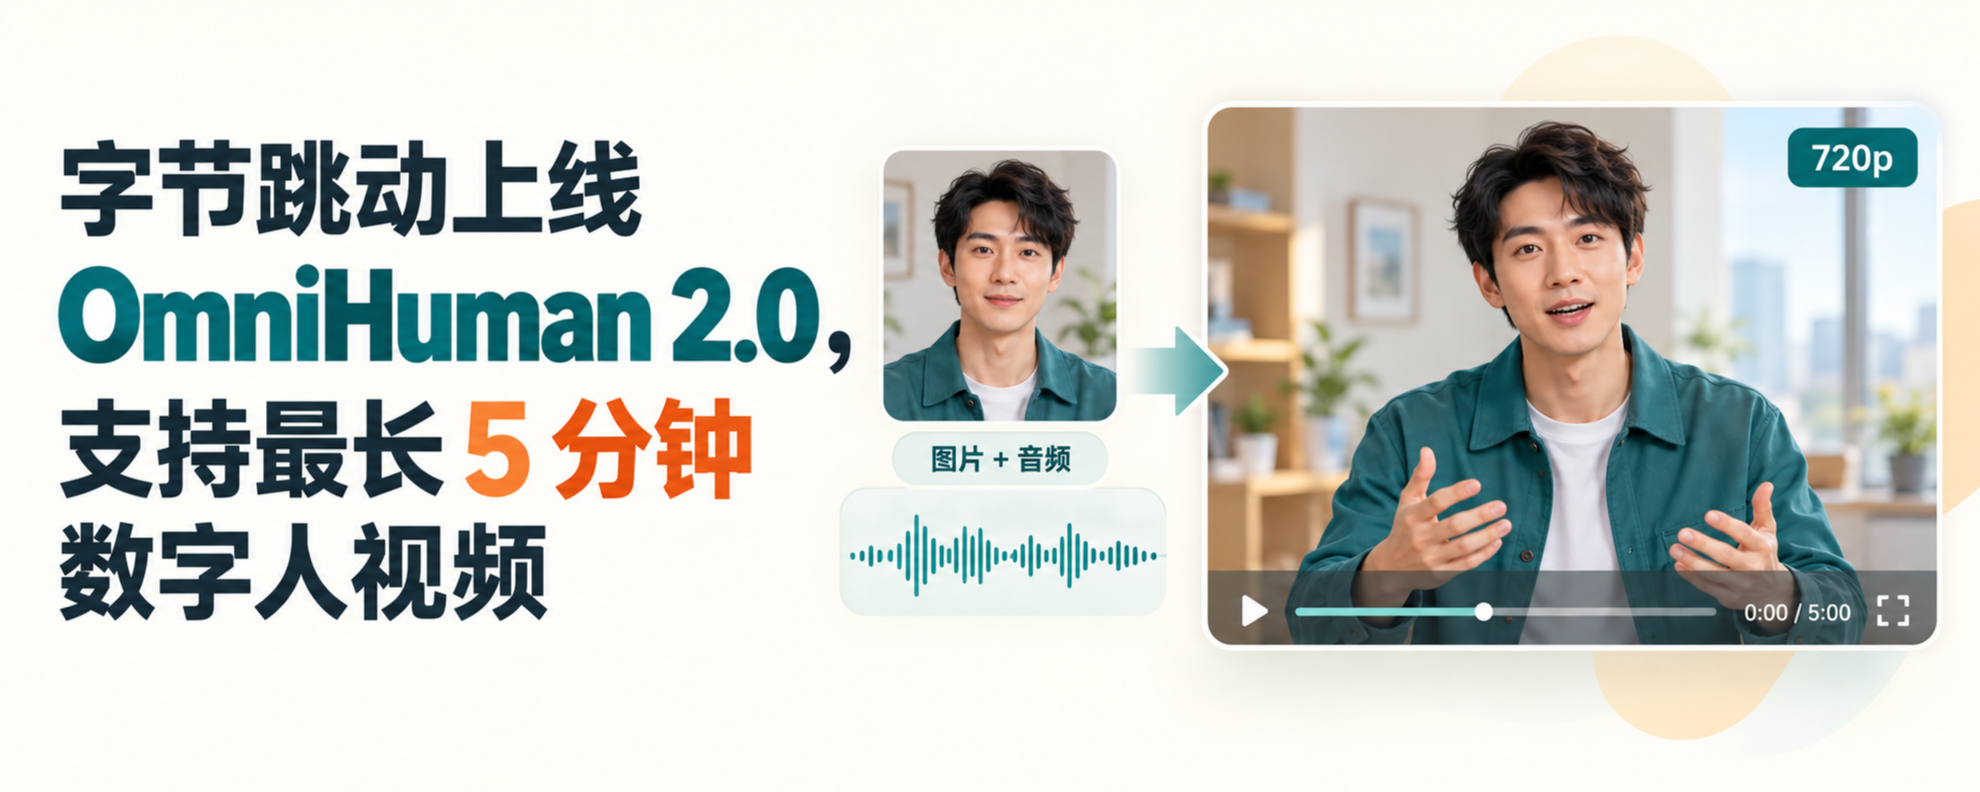
字节跳动的 OmniHuman 2.0 已通过 BytePlus 上线,输入一张图片和一段音频即可生成数字人视频,也可用文字指定动作与镜头运动。模型支持原生 720p 输出,音频输入最长 300 秒;按每秒 0.07 美元标价计算,生成 1 分钟视频约需 4.20 美元。
产品介绍:让图片中的角色按音频表演
OmniHuman 2.0 是字节跳动的数字人视频生成模型。数字人指由 AI 驱动、在视频中说话或表演的角色;制作时提供一张角色图片和一段音频,模型生成与声音配合的口型、表情及肢体动作。音频可以是讲话、音乐或对白,文字提示词则用于补充场景、动作和运镜要求。
模型支持原生 720p 视频输出,可处理多人场景,展示的角色类型也包括动漫、动物和 3D 风格形象。用户可以从 OmniHuman 2.0 产品页面 进入 BytePlus 控制台,或查看 API 接入方式。API 是供软件调用模型的接口,适合把生成能力接入已有的内容制作工具。
最长 5 分钟,文字可指定动作与运镜
OmniHuman 2.0 的音频输入范围为 4–300 秒,对应最长 5 分钟的视频生成任务。准备口播、歌曲表演或对白片段时,可以先确定完整音轨,再用角色图片驱动画面。
文字提示词是可选输入,用来指定场景、人物动作和摄像机运动。例如,可以描述角色抬手、转身,或镜头逐渐拉近。提示词支持中文、英语、日语、韩语、西班牙语(墨西哥)和印尼语;这项语言范围针对文字指令。
这一工作流程从已有图片和音轨出发。需要了解多素材参考、视频延长与局部修改的读者,可以参阅 Seedance 2.5 的视频生成与定向编辑功能,按手头素材和修改需求选择工具。
如何使用:先准备图片和音轨
通过 BytePlus 入口登录后,可按 OmniHuman 2.0 API 文档 准备素材。素材规格如下:
| 素材 | 要求 |
|---|---|
| 音频 | WAV 或 MP3,时长 4–300 秒,文件小于 15 MB |
| 图片 | JPEG、PNG、WebP、BMP、TIFF、GIF、HEIC 或 HEIF,文件小于 30 MB |
| 图片尺寸 | 像素尺寸在 300–6000 范围内,宽高比为 0.4–2.5 |
| 文字提示词 | 可选,用于指定场景、动作和镜头运动 |
开发者接入采用异步任务流程:提交图片、音频和可选提示词后,先取得任务编号,再查询处理状态;任务完成后返回视频地址。这样可以把生成任务放入后台队列,完成后再交给剪辑或内容管理流程。
费用与适用人群
BytePlus 产品页的 OmniHuman 2.0 标价为每秒 0.07 美元。按该单价计算,30 秒视频约 2.10 美元,1 分钟约 4.20 美元,5 分钟约 21 美元。这些是按时长乘以单价计算的单次生成费用;多次生成应分别计入预算。
适合这类工作流程的人群包括已有口播录音的知识创作者、制作商品讲解的电商团队,以及希望给歌曲配上角色表演画面的音乐创作者。动漫或虚拟形象创作者也可以从现成角色图片开始制作。
第一次使用时,可以先选一段包含停顿、情绪变化或明显节奏的短音频,检查口型、手部动作和镜头指令是否符合制作要求,再提交较长内容。按上述单价,15 秒样片约需 1.05 美元,便于在制作长片前确认素材与提示词的组合。
原始来源
以下资料用于核对本文信息;价格、开放范围与产品状态请以来源的最新说明为准。
- OmniHuman 2.0 Official API — BytePlus — 产品入口、图片与音频输入、文字控制、720p 输出、最长 300 秒及每秒 0.07 美元标价
- OmniHuman 2.0 API Document — 图片与音频规格、提示词语言、异步任务提交与结果查询